미국과 중국을 빼고 보면 누가 AI를 실제로 만들고, 굴리고, 자기 산업에 붙일 수 있을까요. 이 글은 그 질문에 바로 답하기 위해 글로벌 AI 순위를 새로 잡습니다. Stanford식 종합 지수 대신, 독자가 체감할 수 있는 세 가지만 봅니다. 첫째, 유료 서비스로 팔거나 오픈 웨이트로 공개할 만한 한국 AI 모델이 있는가. 둘째, 그 모델을 계속 학습·운영할 GPU, 자본, 연구조직이 있는가. 셋째, 인터넷에서 사 온 데이터 말고 자기 나라의 행정·산업·언어 데이터가 실제 AI 학습과 서비스로 이어질 수 있는가입니다. 어디까지나 AI를 이용한 분석을 통한 제 주관적인 해석이니 그냥 재미로 보시기 바랍니다.
여기서 말하는 순위는 국제기구의 공식 순위가 아닙니다. “미·중 모델을 사 와서 쓰는 나라”와 “자국 언어와 산업에서 쓸 모델·인프라·데이터를 어느 정도 스스로 확보한 나라”를 가르는 편집상 실력 순위입니다. 가중치는 모델 보유력 50%, AI GPU 인프라·자본·연구조직 30%, 자체 데이터 역량 20%입니다. 이 기준이면 유럽은 한 국가가 아니라 공동 시장·연구·컴퓨팅 권역으로 평가합니다. 미국,중국이야 너무 유명하니 논외로 치겠습니다.
결론부터: 미국·중국 밖의 체감 AI 실력 순위
아래 점수는 성능 벤치마크의 소수점이 아니라 위 세 기준을 A~C 등급으로 판단해 환산한 값입니다. A는 해당 층을 자국 주도로 생산·운영할 수 있는 상태, B는 대표 모델·프로그램은 있으나 공급망 또는 규모의 빈칸이 남은 상태, C는 현지화 모델·도입은 가능하지만 대규모 자립은 어려운 상태입니다. 8.5 같은 소수점은 이 가중치를 드러내기 위한 표기일 뿐 성능의 정밀 측정값이 아닙니다. 그래서 “ChatGPT보다 몇 점 낮은가”를 말하지 않습니다. 대신 자기 모델을 만들고, 계속 돌리고, 자기 데이터로 일을 시킬 수 있는가를 말합니다.
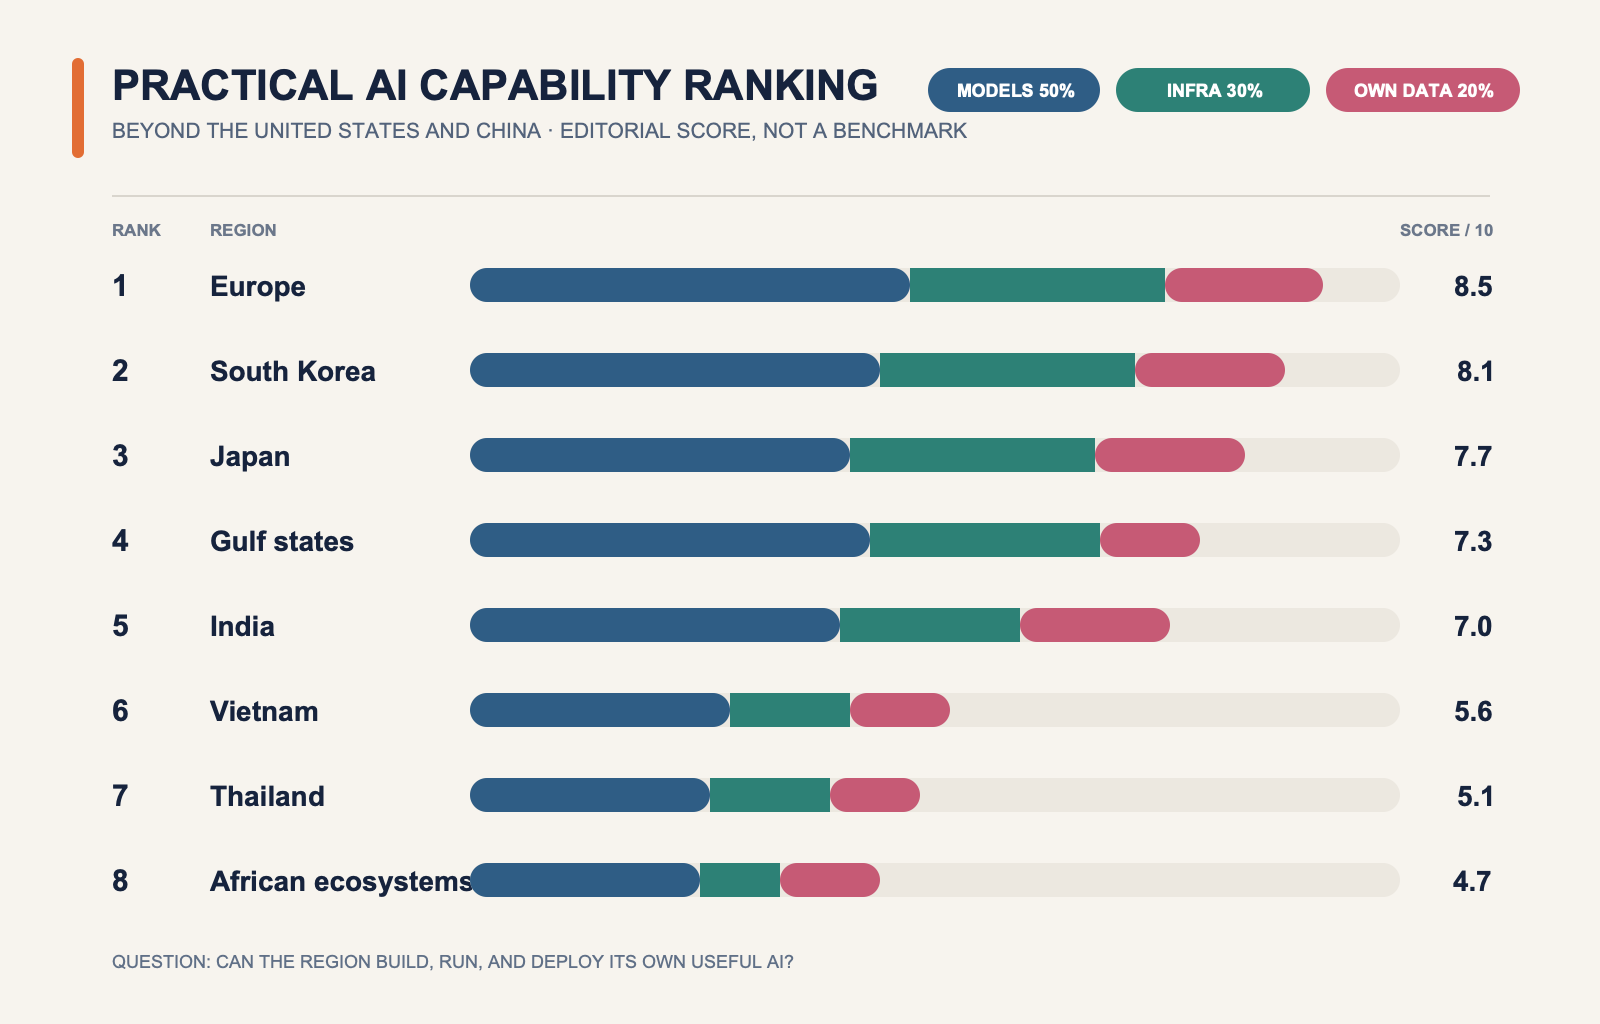
| 순위 | 권역·국가 | 모델 보유력 50% | 인프라 30% | 자체 데이터 20% | 한 줄 판정 |
|---|---|---|---|---|---|
| 1 | 유럽연합 권역 | A- | A | A- | Mistral 계열과 거대한 연구·산업·공동 컴퓨팅을 동시에 보유한 가장 두꺼운 비미중 권역 |
| 2 | 한국 | B+ | A | A- | 세계 최정상 범용 모델은 아니지만, 한국어 모델·HBM·제조 데이터·정부 GPU 지원이 한 묶음으로 움직임 |
| 3 | 일본 | B | A- | A | 세계 모델 순위보다 일본어·제조·공공에 맞춘 장기 자립 경로가 강함 |
| 4 | 걸프권(UAE·사우디 중심) | B+ | A- | B | Falcon·Jais·ALLaM과 막대한 GPU·전력·자본이 강점, 연구층과 자체 데이터의 폭은 아직 얇음 |
| 5 | 인도 | B | B | A- | 인재·디지털 공공망·언어 시장은 크지만, 최상급 GPU와 독자 칩·대형 모델의 깊이는 제한적 |
| 6 | 베트남 | C+ | C | B | 베트남어 모델과 국가 데이터 전략이 빠르지만 대규모 학습 인프라는 이제 구축 단계 |
| 7 | 태국 | C | C | B- | Typhoon 같은 태국어 오픈 모델과 공공 도입은 보이나, 컴퓨팅·자본 규모가 작음 |
| 8 | 아프리카 지역 생태계 | C | C- | B- | 언어 공동체·모바일·핀테크 데이터는 강점이지만 국가별 전력·GPU·자본 격차가 매우 큼 |
이 표의 핵심은 1위가 “유럽의 어느 한 회사가 GPT를 이겼다”는 뜻이 아니라는 점입니다. 유럽은 프랑스의 Mistral 같은 상용 모델 회사, 독일·프랑스·이탈리아 등의 연구기관, 산업 데이터, EU AI Factory를 합친 권역 점수입니다. 반대로 한국 2위는 모델 하나의 세계 순위가 아니라 반도체와 제조 데이터가 붙어 있다는 점 때문에 올라갑니다.
첫 번째 기준: 돈을 받고 팔거나, 공개해서 쓸 모델이 있는가
첫 번째 질문은 단순합니다. 그 나라에 “국내 언어와 기업 업무에 써도 될 수준”의 상용 모델이 있습니까? 없더라도 개발자가 가중치·코드·기술 문서를 받아 자체 서비스로 고칠 수 있는 오픈 모델이 있습니까? Hugging Face에 등록된 파생 모델 개수를 세지 않는 이유는, 같은 기반 모델을 미세조정한 저장소 수가 실력을 부풀리기 때문입니다. 여기서는 상용 API·제품으로 지속 운영되거나, 가중치·코드·기술 문서가 공개된 대표 모델만 봅니다.
| 권역·국가 | 확인할 수 있는 대표 모델·흐름 | 모델 기준 판정 |
|---|---|---|
| 유럽 | 프랑스의 Mistral Large·Mistral Small 계열, 다수의 공개 가중치 모델 | 비미중권에서 유일하게 세계 상용 모델 시장에 뚜렷이 보이는 층. 다만 2024년 Stanford AI Index의 ‘notable model’ 수에서도 유럽은 3개로, 미국·중국과 같은 깊이는 아니었습니다. |
| 한국 | NAVER HyperCLOVA X 상용 서비스, LG AI Research EXAONE 4.0 공개 32B, 통신사·국가 프로젝트 모델 | 한국어·업무 특화에서 바로 쓸 모델층이 있습니다. 다만 세계 최상단 범용 폐쇄형 모델군과 동급이라고 단정할 근거는 부족합니다. |
| 일본 | LLM-jp 공개 모델, GENIAC 지원 일본어 특화 LLM, PFN·NICT·Sakura Internet 협력 | 영어권 전면 승부보다 일본어·제조·공공용 소버린 모델을 쌓는 경로입니다. LLM-jp는 172B 공개 베타를 포함해 학계·산업 공동체가 만든 기반입니다. |
| 걸프권 | UAE의 Falcon H1·Falcon Arabic, Jais; 사우디의 ALLaM 34B | 아랍어와 공개 모델에서는 이미 존재감이 분명합니다. 특히 UAE는 모델 공개를 인재·외교·생태계 전략으로도 씁니다. |
| 인도 | Sarvam·Krutrim 등 인도 언어권 모델, IndiaAI의 모델·데이터·도구 플랫폼 | 거대한 다언어 수요를 겨냥한 모델은 늘고 있습니다. 다만 초거대 범용 모델의 세계 성능 경쟁에서는 아직 추격 그룹입니다. |
| 베트남·태국 | 베트남 PhoGPT, 태국 Typhoon-7B와 후속 태국어 모델 | 둘 다 “자국어를 외국 모델에만 맡기지 않겠다”는 최소 조건은 만들었습니다. 그러나 모델 크기·학습 자원·기업 배포 폭은 상위 그룹과 차이가 큽니다. |
| 아프리카 | Masakhane 같은 다언어 오픈 연구·번역 모델 공동체 | 아프리카는 한 나라로 묶을 수 없습니다. 공통 과제는 2,000개가 넘는 저자원 언어에서 학습 데이터와 평가셋을 만드는 일입니다. |
이 기준에서 유럽이 1위, 한국이 2위인 이유는 간단합니다. 유럽은 Mistral처럼 글로벌 고객에게 팔 수 있는 모델 사업이 있고, 한국은 HyperCLOVA X·EXAONE처럼 한국어 상용·공개 모델을 둘 다 갖췄습니다. 일본·걸프·인도도 모델을 보유했지만, 각각 언어권·국가 프로젝트·지역 시장에서 강하고 세계 범용 시장의 두께는 한 단계 아래입니다.
두 번째 기준: GPU·칩·돈·연구 인프라가 갖추어져 있는가
모델 한 번 공개하는 것과 2년 뒤에도 다음 세대 모델을 만드는 것은 다릅니다. 이 단계는 GPU를 얼마나 샀는지, 전력과 데이터센터를 늘릴 자본이 있는지, 대학·연구소·기업이 한 팀처럼 이어지는지를 봅니다. AI GPU 인프라는 단순히 서버를 사는 문제가 아니라, 전력·네트워크·운영 인력·장기 자금까지 포함합니다.
- 유럽연합 권역은 가장 넓은 공공 연구층과 공동 인프라를 보유합니다. 유럽연합 집행위원회는 2025년 10월 기준 16개 회원국의 19개 AI Factory를 발표했습니다. 강점은 여러 나라의 스타트업·대학·중소기업이 접근할 수 있게 만든 점입니다. 약점은 최상급 GPU 설계와 클라우드의 상당 부분을 미국 공급망에 의존하고, 국가별 의사결정이 느리다는 점입니다.
- 한국은 GPU를 직접 설계하는 나라는 아니지만, HBM과 메모리·파운드리·제조 공급망을 갖췄습니다. 과기정통부는 2026년까지 정부 조달 1만5천 장을 포함해 누적 3만7천 장의 GPU를 확보하겠다고 밝혔고, 소버린 AI 프로젝트에는 GPU와 데이터를 지원하고 있습니다. 즉 “칩을 전부 국내에서 만들었다”가 아니라, AI 컴퓨팅을 산업 전략과 연결할 실물 기반이 강하다는 뜻입니다.
- 일본은 GENIAC을 통해 기반 모델 개발에 필요한 컴퓨팅을 지원하고, 정부·연구기관·통신·제조 기업을 한 생태계로 묶으려 합니다. 2026년 4차 지원에서 16개 프로젝트가 선정됐습니다. 일본의 강점은 자본·제조업·연구기관의 폭이고, 약점은 GPU 공급망과 빠른 제품화에서 미국 기업에 기대는 부분입니다.
- 걸프권은 가장 공격적인 자본형 추격자입니다. UAE는 Falcon을 만든 TII와 G42를, 사우디는 SDAIA와 대형 국가 투자 계획을 앞세웁니다. GPU와 데이터센터를 대량 조달할 돈·전력·정치적 결정 속도는 강하지만, 반도체 제조와 대학·스타트업의 다층 연구 생태계는 유럽·한국·일본보다 얇습니다.
- 인도는 엔지니어 인력과 소프트웨어 산업은 매우 크지만, 최고급 GPU와 칩 생산은 아직 수입 의존도가 높습니다. IndiaAI Compute는 공공·대학·스타트업에 1만 장 이상 GPU 규모의 공공 클라우드를 제공하는 방향입니다. 이는 좋은 출발이지만 유럽의 공동 슈퍼컴퓨팅이나 한국·일본의 산업 공급망과 같은 층위는 아닙니다.
- 베트남·태국·아프리카는 지역 모델과 서비스 도입 속도에 비해 대형 학습용 GPU·전력·장기 자본이 부족합니다. 그래서 지금 단계의 현실적인 전략은 미국·중국 모델을 그대로 재판매하는 것이 아니라, 더 작은 공개 모델을 현지 언어·정부·금융·제조 데이터에 맞게 튜닝하고 필요한 컴퓨팅을 공동으로 확보하는 것입니다.
세 번째 기준: ‘데이터가 많다’가 아니라 ‘자기 데이터로 학습·운영할 수 있는가’
자체 데이터는 인터넷에서 긁거나 구매하는 문서가 아닙니다. 행정 절차, 공장 설비, 병원 기록, 금융 거래, 물류 흐름, 지역 언어와 고객 상담처럼 그 나라에서만 나오는 데이터입니다. 그러나 디지털화가 잘됐다고 자동으로 AI에 쓸 수 있는 것은 아닙니다. 개인정보·영업비밀·저작권·부처 소유권·낮은 품질을 넘어, 합법적 접근권·정제·라벨링·운영 책임까지 있어야 AI-Ready 데이터가 됩니다.
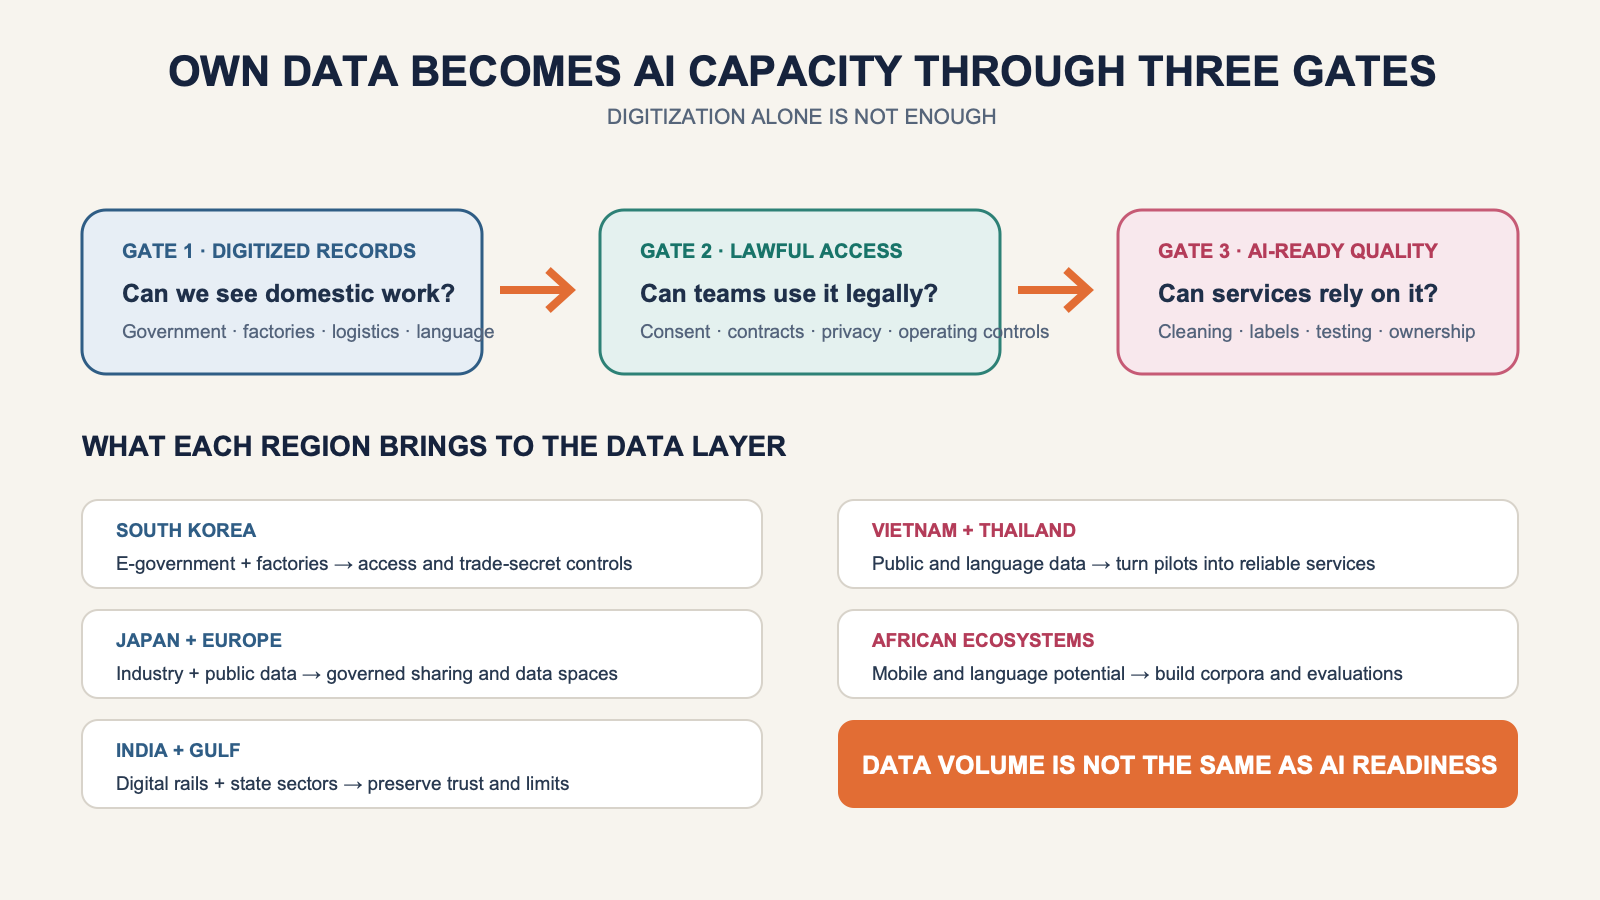
- 한국은 전자정부, 통신, 금융, 제조 현장의 데이터 밀도가 높습니다. 특히 반도체·자동차·조선·물류·공장의 설비 데이터는 외국 모델이 쉽게 복제하기 어려운 자산입니다. 다만 이 데이터는 기업과 기관 안에 흩어져 있고, 개인정보·산업기밀 때문에 “국가 데이터가 많으니 모델이 바로 학습한다”는 식의 주장은 틀립니다. 한국의 승부는 안전한 반출, 연합학습, 비식별화, 현장 도입으로 이 벽을 넘는 데 있습니다.
- 일본도 제조·로봇·정밀장비·공공 기록이라는 두꺼운 데이터층이 있습니다. 대신 오래된 시스템, 기업별 사일로, 보수적인 조달 구조가 데이터 결합의 속도를 늦출 수 있습니다. 일본 정부의 GENAI는 법령·관보·부처 지식베이스를 연결해 정부 안에서 먼저 쓰는 방식을 택했습니다. 이는 “데이터를 무조건 공개”하는 것보다, 권한 안에서 쓸 수 있는 데이터 제품을 만드는 접근입니다.
- 유럽은 자동차·기계·의료·금융·과학 연구 데이터가 강합니다. GDPR과 AI Act는 개인 데이터와 고위험 이용의 속도를 늦출 수 있지만, 그것이 데이터가 없다는 뜻은 아닙니다. 유럽의 방향은 산업 데이터 공간과 공통 규칙으로 국경을 넘는 신뢰 가능한 접근을 만드는 것입니다. 성공하면 제조 AI에는 큰 강점이 되지만, 규칙과 계약을 맞추는 비용은 실제 약점입니다.
- 인도는 Aadhaar·UPI 등 디지털 공공 기반과 거대한 다언어·모바일 시장이 큰 자산입니다. 동시에 개인정보 보호와 공공 데이터 이용의 신뢰를 같이 세우지 못하면, 데이터 규모가 오히려 사회적 위험이 됩니다. 인도의 장점은 소비자·행정·결제 데이터가 만나는 넓이이고, 과제는 이를 다양한 언어에서 공정하게 정제·평가하는 일입니다.
- 걸프권은 정부 서비스, 에너지, 물류, 금융처럼 국가 주도 부문의 데이터와 신속한 집행력이 있습니다. 반면 인구·언어 데이터의 절대량과 독립 연구 생태계는 인도·유럽보다 작습니다. 그래서 모델을 크게 만드는 능력보다 아랍어·정부·에너지처럼 선택한 도메인을 깊게 파는 전략이 더 현실적입니다.
- 베트남·태국·아프리카 지역 생태계는 여기서 과소평가하면 안 됩니다. 베트남은 2026~2030 국가 데이터 전략과 AI 법에서 국가·부처·지방 데이터베이스를 AI 인프라의 일부로 다룹니다. 태국은 은행·통신·관광·공공서비스 데이터와 태국어 모델을 연결하는 단계입니다. 아프리카는 모바일·핀테크·지역 언어 데이터의 잠재력이 크지만, 저자원 언어의 말뭉치와 평가셋이 부족합니다. 그래서 Masakhane 같은 공동체가 언어 데이터 자체를 만드는 일이 기반 산업입니다.
이 순위를 어떻게 읽어야 하나
이 글의 결론은 “유럽이 이겼고 나머지는 졌다”가 아닙니다. 미국·중국을 제외했을 때, 유럽은 가장 두꺼운 복합 권역, 한국은 가장 산업 연결성이 높은 추격자, 일본은 가장 오래 버틸 일본어·제조 자립 경로, 걸프권은 가장 빠르게 돈과 GPU를 쌓는 국가 주도 추격자, 인도는 가장 큰 인재·언어·디지털 공공망 보유자입니다. 베트남·태국·아프리카는 최전선 범용 모델 경쟁에서는 뒤에 있지만, 현지 언어와 공공·금융·제조 문제를 먼저 푸는 쪽에서 더 현실적인 기회를 가집니다.
따라서 한 나라의 AI 위치를 볼 때는 이 순서로 보면 됩니다. 먼저 “상용 수준 또는 오픈 웨이트 대표 모델이 있는가”, 다음 “그 모델을 다음 세대까지 학습할 GPU·돈·연구자가 있는가”, 마지막 “자기 산업 데이터에 합법적으로 붙일 수 있는가”입니다. 이 세 질문에 모두 강한 곳만이 AI를 소비하는 나라를 넘어 AI를 운영하는 나라가 됩니다. 일본 디지털·AI 시장에 진출하려는 기업이나, AI 안전의 국제 의제를 보는 개발자에게도 이 순서가 더 실용적인 기준입니다.
앞으로 AI의 헤게모니를 쥐는 나라가 모든 분야에서 타국을 압도할 것으로 예상됩니다. 노동집약적인 제조업이 피지컬 AI 발전으로 인건비를 0로 만들어버리는 시대이니까요. 모든 산업의 공식, 자본의 흐름 모든것이 급변할 것입니다. 여기서 미국,중국은 이미 저 만치 앞서가는 것이 체감이 될 정도이니 우리나라도 부지런히 발전하길 기대합니다.
출처
- Stanford HAI, AI Index Report 2025 및 2026 Technical Performance
- European Commission, AI Factories Antennas, 2025
- 대한민국 과학기술정보통신부, 소버린 AI 모델·K-AI 지원 및 GPU 확보 계획, 2026
- LG AI Research, EXAONE 4.0 공식 저장소; NAVER, HyperCLOVA X
- 일본 METI, GENIAC 및 16개 AI 모델 프로젝트 선정; 일본 디지털청, Government AI GENAI
- UAE ATRC, Falcon H1·Falcon Arabic; 사우디 SDAIA, National Data & AI Strategy
- IndiaAI, Compute policy 및 AI cloud portal
- 베트남 정부, National Data Strategy 및 AI Law; SCB 10X, Typhoon; Masakhane



댓글 없음:
댓글 쓰기