ChatGPT에서 말하는 “루프”는 대개 정해진 시각에 작업을 다시 실행하는 Scheduled Tasks를 뜻합니다. 저장소를 고치고 테스트하는 반복 작업은 Codex 자동화로 분리해서 생각하면 쉽습니다.
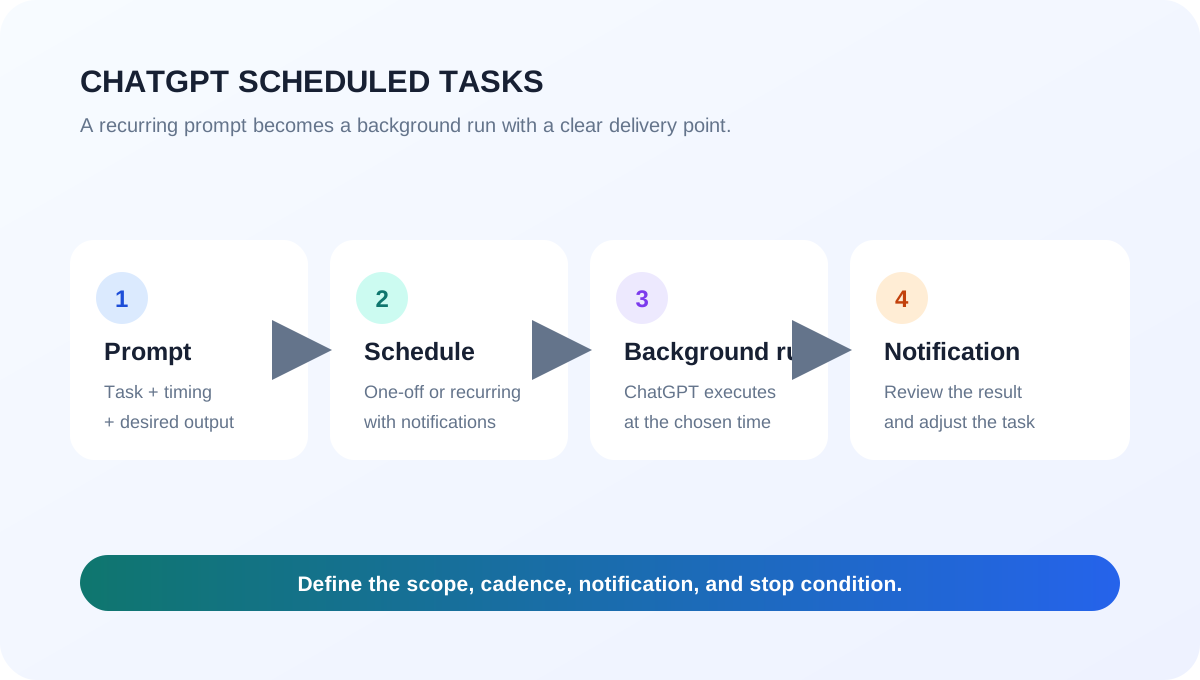
<ChatGPT Scheduled Tasks의 반복 실행 흐름 1.1>
1. GPT 루프 기능의 개요
Scheduled Tasks는 일회성 또는 반복 프롬프트를 백그라운드에서 실행하고, 결과를 알림으로 알려주는 기능입니다. 매일 브리핑, 주간 리포트, 특정 변화 모니터링에 적합합니다. 자세한 지원 범위는 ChatGPT Scheduled Tasks 공식 안내에서 확인할 수 있습니다.
목적
적합한 기능
알림·브리핑·변화 감시
ChatGPT Scheduled Tasks
저장소 수정·테스트·검증
Codex Automations 또는 장기 작업
2. 데스크톱 프로그램에서 사용법
ChatGPT 데스크톱 앱에서 왼쪽 위 ChatGPT 메뉴 → Scheduled를 엽니다. 새 작업을 만들고 “매주 월요일 오전 9시에 지난주 AI 뉴스를 세 줄로 요약해줘”처럼 내용과 주기를 입력한 뒤 확인 카드를 저장하면 됩니다. 같은 화면에서 다음 실행 시각을 확인하고 일시정지·재개·수정·삭제할 수 있습니다. 알림은 Settings → Notifications에서 관리합니다.
로컬 프로젝트를 대상으로 예약할 때는 프로젝트가 디스크에 남아 있고 앱과 컴퓨터가 실행 중이어야 합니다. 웹에서 만든 작업은 로컬 폴더를 직접 유지하지 않습니다.
3. Codex에서의 사용법
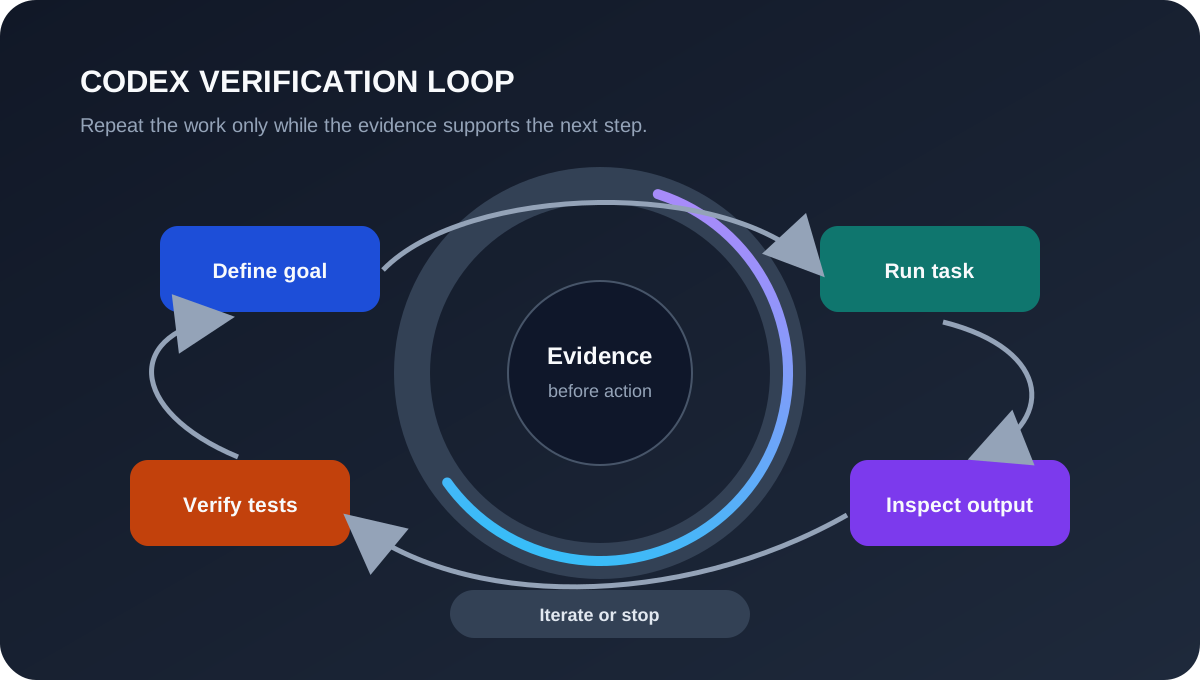
Codex에는 ChatGPT의 Scheduled 관리 메뉴가 없습니다. 대신 Codex Automations 또는 장기 작업에 다음 네 가지를 명시합니다.
대상 저장소와 작업 범위
실행 주기 또는 시작 조건
성공 판정과 결과물 형식
중단 조건과 사람의 승인 지점
예를 들어 “매일 오전 9시에 이 저장소의 테스트를 실행하고 실패 항목만 요약해. 같은 오류는 세 번까지만 재시도하고 파일 수정은 승인 후 진행해”처럼 요청합니다. Codex의 Automations 안내와 사용 사례를 함께 보면 저장소 작업을 더 구체화할 수 있습니다.
<Codex 작업을 안전하게 반복하는 검증 루프 1.2>
4. 사용 시 팁과 주의점
먼저 일반 대화에서 프롬프트를 시험하고 첫 몇 회의 결과를 확인하세요. 작업은 최소 권한과 좁은 폴더 범위로 시작하고, Codex가 파일을 바꿀 때는 별도 worktree와 테스트를 사용하면 복구가 쉽습니다. Scheduled Tasks는 한 시간보다 자주 실행할 수 없고 플랜별 활성 작업 수 제한이 있으며, 장기간 방치하면 일시정지될 수 있습니다. 음성 대화와 GPTs는 Tasks에서 지원되지 않습니다.
클로드 산업 자동화를 이야기할 때 가장 먼저 바뀌는 것은 모델의 성능표가 아니라 자동화의 시작점입니다. 과거에는 사람이 어느 화면을 열고 어떤 버튼을 누를지 먼저 설계한 뒤, RPA나 API 워크플로우를 연결했습니다. 이제는 “이 문서들을 읽고 판단 기준에 맞는 보고서를 만들어 공유해 달라”는 결과 중심의 지시에서 자동화가 시작될 수 있습니다.
Anthropic은 Claude Code를 코드베이스를 읽고, 파일을 수정하고, 명령을 실행하고, 개발 도구와 연결하는 에이전트 도구로 설명합니다. 최근의 Claude Cowork는 같은 에이전트 구조를 터미널 밖의 지식 업무로 가져와 정리된 문서, 파일 정리, 리서치 결과, 스프레드시트와 프레젠테이션 같은 결과물을 만들도록 확장합니다. 이 글은 그 변화를 바탕으로 Claude가 어떤 자동화 제품과 겹치는지, 실제로 어떤 업무가 바뀌는지를 살펴봅니다.
이 글에서 말하는 “위협”은 기존 제품이 곧 사라진다는 뜻이 아닙니다. Claude가 비정형 입력을 읽고 계획을 세워 여러 도구를 호출하는 범위를 넓히면서, 기존 자동화 제품의 구축 방식·가격·차별화 지점이 압박받는다는 의미입니다. 글의 90%·95% 수치는 공개 벤치마크가 아니라 조건이 맞을 때의 필자 전망입니다.
자동화의 단위가 플로우에서 에이전트로 이동하다
Claude Code에서 Claude Cowork로
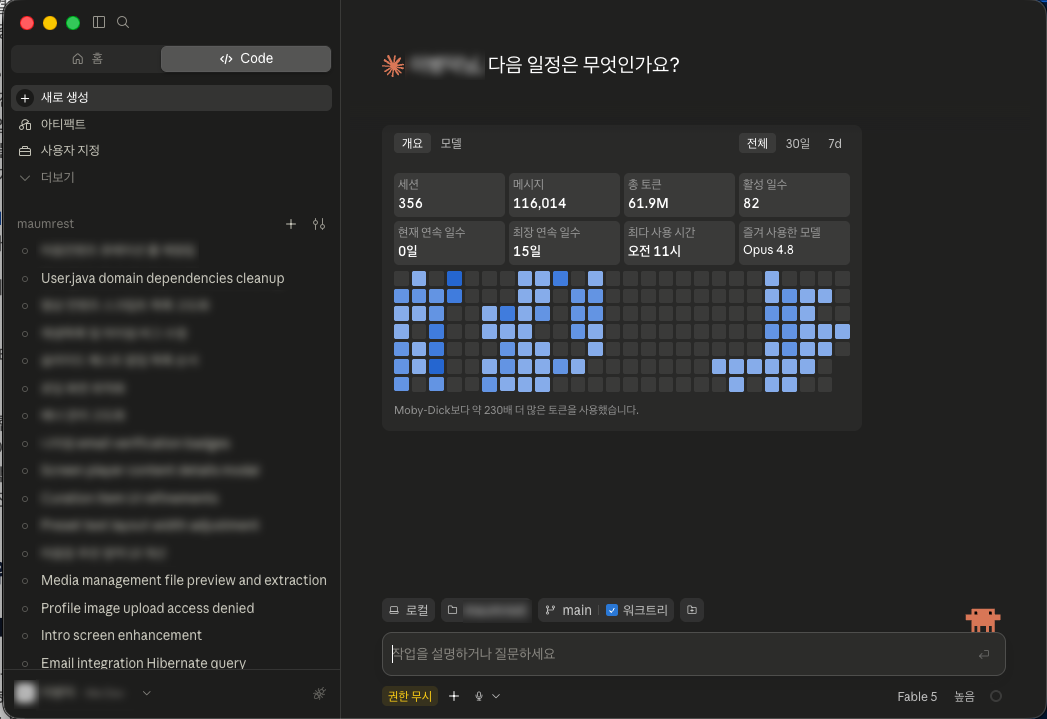
Claude Code의 핵심은 답변을 출력하는 채팅이 아니라 작업을 끝내는 루프입니다. 코드를 읽고, 여러 파일을 수정하고, 명령을 실행하고, 오류를 확인한 뒤 다음 행동을 정하는 과정이 하나의 세션에서 이어집니다. Claude Code 공식 문서는 MCP를 통해 Google Drive·Jira·Slack 같은 외부 도구와 자체 도구를 연결하고, 반복 작업을 예약할 수 있다고 설명합니다.
<Claude Code 작업 현황 화면 1.1>
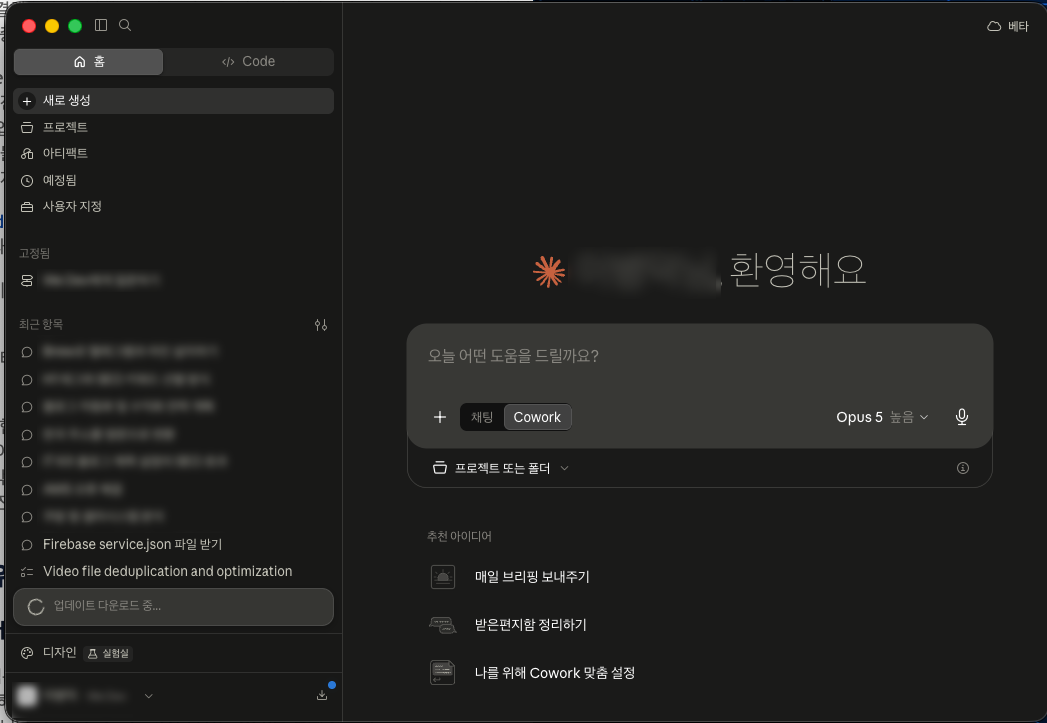
Claude Cowork는 이 구조를 비개발자에게 노출하는 제품입니다. 터미널 명령을 배워야 하는 대신 원하는 결과를 자연어로 설명하면, Claude가 파일과 커넥터를 읽고 여러 단계의 작업을 진행한 뒤 문서·스프레드시트·프레젠테이션 형태로 결과를 남깁니다. Cowork 안내에 따르면 Cowork는 Claude Code의 에이전트 구조를 코딩 밖의 지식 업무로 확장하고, 예약 작업과 프로젝트 단위의 파일·지침·기억을 제공합니다.
<Claude Cowork 시작 화면 1.2>
이 변화의 의미는 개발자가 자동화를 만든다는 전제가 약해진다는 데 있습니다. 개발자는 여전히 권한, 데이터 구조, 예외 처리, 배포를 설계해야 하지만, 업무 담당자는 “무엇을 언제 어떤 기준으로 처리할지”를 설명하는 것만으로 첫 번째 AI 워크플로우를 만들 수 있습니다.
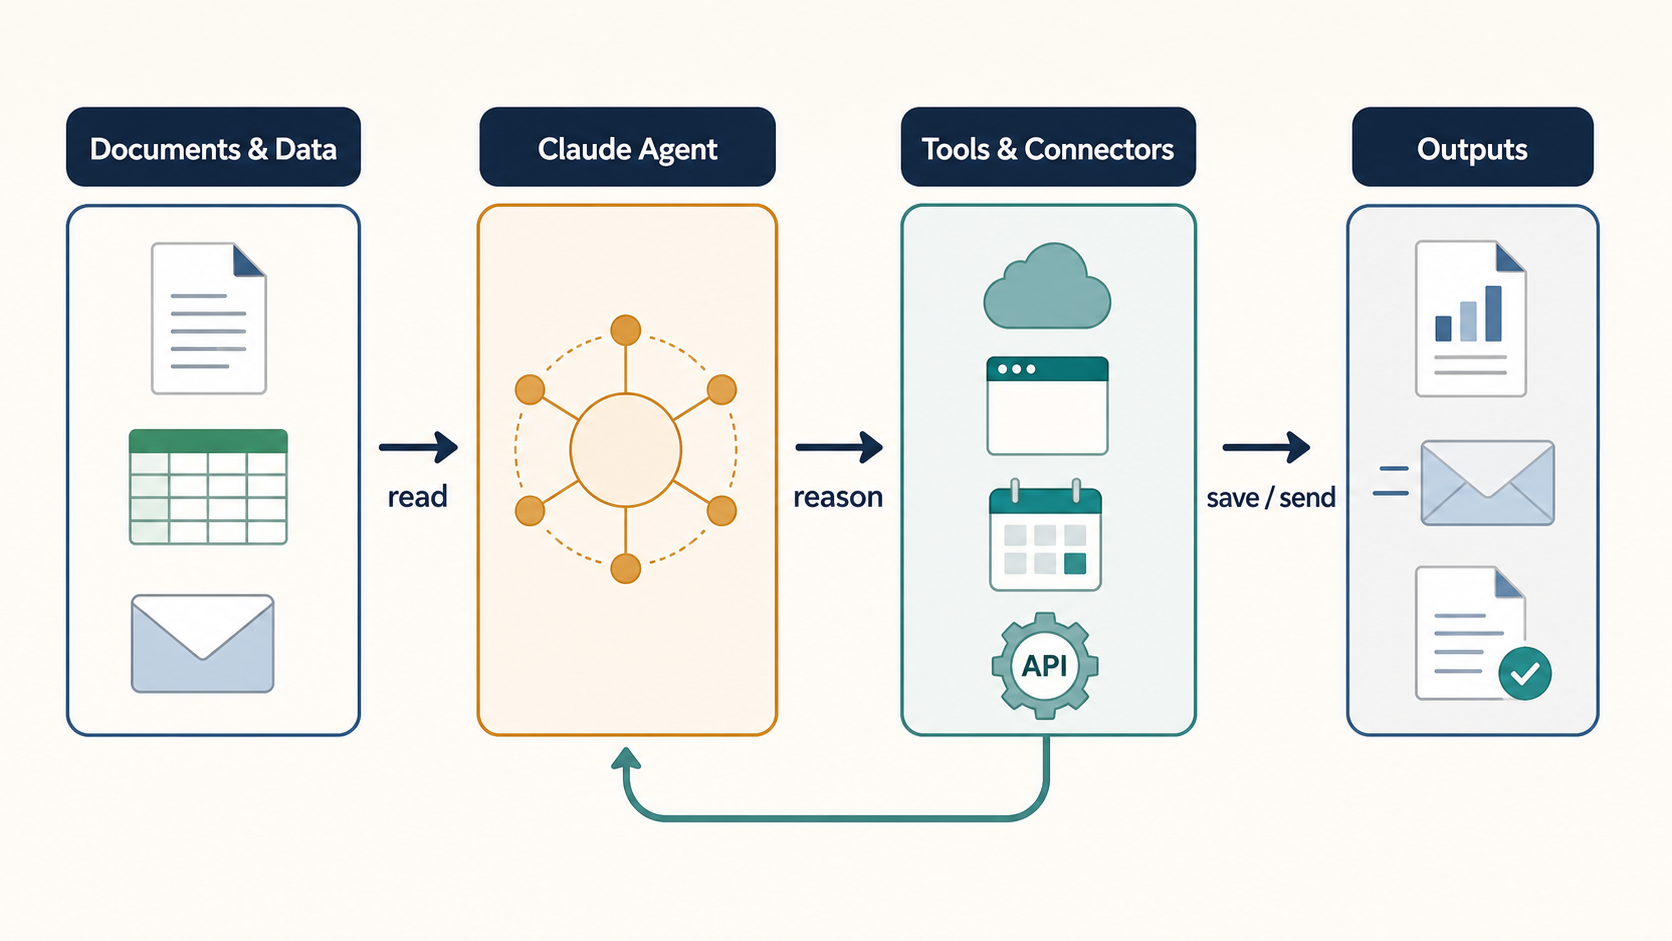
<클로드 에이전트 자동화 루프 1.3>
두 방향의 도구 호출 루프
자동화는 한 방향으로만 흐르지 않습니다. 문서를 읽고 도구를 호출할 수도 있고, 도구에서 먼저 자료를 가져온 다음 문서를 만들 수도 있습니다.
문서에서 시작하는 루프: PDF·Word·스프레드시트·메일을 읽고, 내용을 요약·분류·정리한 뒤, Google Drive에 새 문서로 저장하거나 담당자에게 메일 초안을 만들고, 업무 시스템에 결과를 기록합니다.
도구에서 시작하는 루프: CRM·캘린더·Drive·Slack·내부 API에서 데이터를 가져오고, 여러 결과를 비교·요약한 뒤, 보고서·회의자료·후속 작업 목록을 만들거나 다시 다른 도구로 전달합니다.
Anthropic의 Google Workspace 커넥터 안내는 Gmail·Calendar·Drive를 연결해 검색하고, 문서를 만들고, 생성한 파일을 Drive에 저장하는 흐름을 설명합니다. 커넥터가 없을 때는 Cowork의 컴퓨터 사용 기능이 브라우저나 화면을 직접 조작할 수 있지만, 현재 연구 미리보기이며 커넥터보다 느리고 오류 가능성이 높습니다.
기존 RPA의 핀셋영역은 “컴퓨터의 어느 위치에서 어떤 데이터를 읽고, 어떤 도구에 어떤 형식으로 전송하거나 저장할 것인가”였습니다. 화면 좌표, 셀 위치, 파일명, 로그인 계정, 예외 화면을 모두 미리 정의해야 했기 때문입니다. LLM 에이전트는 이 중 일부를 문맥을 읽고 계획하는 문제로 바꾸지만, 반복성이 높은 업무와 엄격한 감사가 필요한 업무에서는 RPA와 API가 여전히 더 적합합니다.
클로드가 압박하는 자동화 제품 지도
Claude가 기존 제품을 모두 대체하는 것은 아닙니다. 다만 자동화의 첫 설계 단계에서 자연어로 목표를 설명하고, 비정형 문서를 읽고, 필요한 도구를 선택하는 일이 가능해지면서 아래 제품군과 겹치는 면적이 빠르게 커지고 있습니다.
영역
겹쳐지는 제품군
Claude와 겹치는 지점
기존 제품이 여전히 강한 지점
화면·RPA 자동화
UiPath Platform, Power Automate Desktop, Automation Anywhere, Blue Prism
Microsoft 365 Copilot·Workflows, Google Workspace·Gemini, Notion 계열
파일 요약, 회의자료·보고서 생성, 팀 지식 검색과 후속 작업
테넌트 보안, 계정·공유 권한, 조직 내 저장소와 기본 통합
제품 관점에서 가장 먼저 압박받는 것은 “간단한 자동화를 만들어 주는 구축 서비스”입니다. 과거에는 작은 팀이 이메일 수신, 파일 분류, 요약, 알림 전송을 연결하려면 iPaaS 화면에서 트리거와 액션을 하나씩 골라야 했습니다. 이제는 Claude가 목표와 데이터 위치를 이해하고 첫 설계를 만들 수 있으므로, 단순 연결의 가치가 낮아집니다.
반대로 기존 자동화 플랫폼은 Claude를 적으로만 보지 않습니다. UiPath는 에이전트·로봇·도구·사람을 하나의 제어 영역에서 묶는 방향으로 가고 있고, Microsoft는 에이전트가 판단하고 워크플로가 구조와 감사 기록을 맡는 결합을 설명합니다. 즉, 기존 제품의 다음 경쟁력은 “버튼을 대신 누르는 로봇”이 아니라 다양한 모델과 에이전트를 안전하게 배치하고 관찰하는 운영 체계가 됩니다.
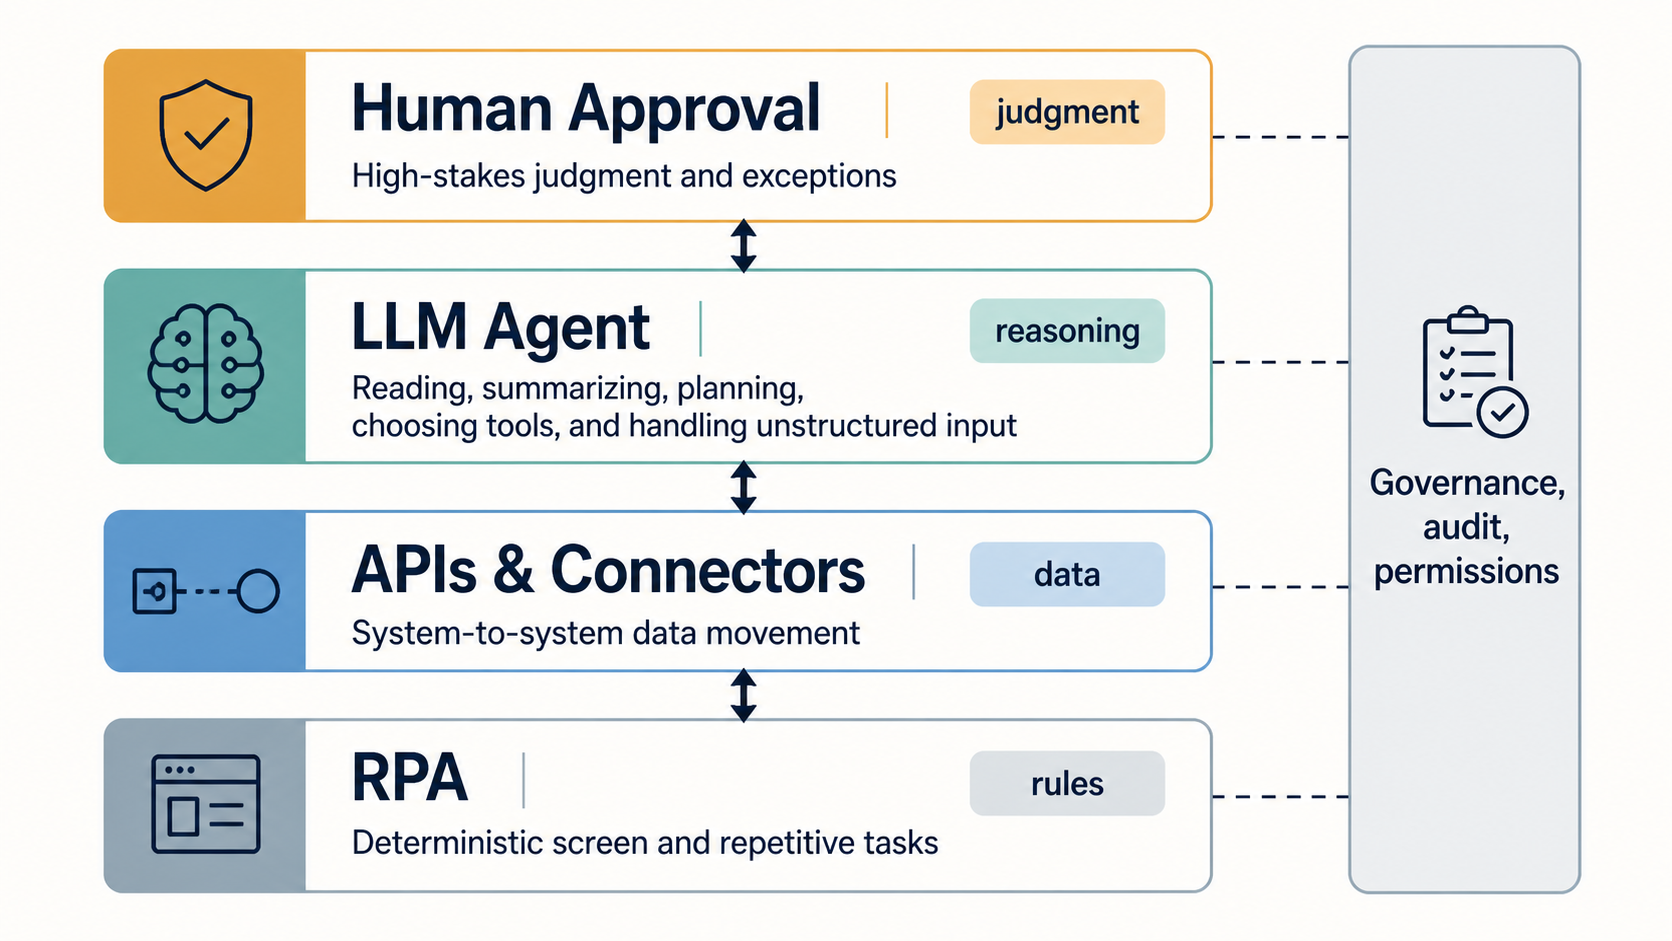
<RPA·API·LLM 에이전트의 역할 경계 2.1>
이런 관점에서 보면 Claude는 RPA 자동화 제품 하나와 경쟁하는 것이 아니라 자동화 시장의 상단을 넓히는 촉매에 가깝습니다. RPA가 정해진 화면 작업을 담당하고, API가 시스템 사이의 안정적인 통로를 제공하며, LLM 에이전트가 비정형 입력을 해석하고 다음 행동을 계획하는 조합이 현실적인 구조입니다.
비개발자 업무의 90%가 자동화되는 조건
클라우드 저장소와 파일 형식이 업무의 기반이 된다
에이전트 자동화의 성패는 모델 하나보다 도구의 역할에 달려 있습니다.
Google Drive·SharePoint·Dropbox 같은 클라우드 저장소는 파일을 공동으로 보관하고 공유하는 기준점이 됩니다.
동기화 폴더와 데스크톱 커넥터는 LLM이 로컬 파일에 접근해야 할 때 수동 업로드를 줄여 줍니다.
Word·Excel·PowerPoint·PDF·TXT·Markdown 같은 문서 도구와 파서는 파일을 열고 구조를 읽는 입구입니다. HWP처럼 특정 지역에서 많이 쓰는 형식은 연결 도구가 실제 파싱을 지원하는지 별도로 확인해야 합니다.
API·MCP·셸 스크립트는 결과를 다른 시스템으로 전송하거나 신규 파일을 생산하는 출구가 됩니다.
Claude는 이미 파일을 읽는 데서 멈추지 않고, 파일 생성·편집 기능을 통해 Excel·PowerPoint·Word·PDF 같은 결과물을 만들 수 있다고 안내합니다. 파일을 읽고 요약하는 모델과 파일을 생산·전송하는 도구가 하나의 대화 안에서 연결되면, 업무 담당자는 각 제품의 메뉴보다 처리할 목적과 승인 기준에 집중하게 됩니다.
마케팅 플랜과 정형 분석은 빠르게 자동화된다
마케팅 플랜을 예로 들면 시장 자료 수집, 경쟁사 목록화, 고객군 분류, 캠페인 가설 작성, 일정표와 예산 초안, 보고서와 발표자료 생성까지 이어지는 흐름이 있습니다. 사람이 해야 하는 것은 무엇을 조사할지와 어떤 제약을 지킬지를 정하는 일이고, 자료를 읽고 초안을 조립하는 대부분의 단계는 에이전트가 처리할 수 있습니다.
필자는 조건이 잘 정의된 마케팅 플랜의 문서 작성과 결과물 생성 과정은 약 90%까지 자동화될 수 있다고 봅니다. 다만 시장 수치가 최신인지, 경쟁사 정보가 사실인지, 예산과 법적 표현에 문제가 없는지는 사람이 확인해야 하므로 “캠페인 전체가 90% 자동 집행된다”는 뜻은 아닙니다.
정해진 포맷의 분석·요약·플랜·결과물 생산은 더 높은 자동화율을 기대할 수 있습니다. 입력 문서가 충분하고, 출력 형식이 정해져 있으며, 외부 시스템에 쓰기 전 승인 단계가 있다면 필자는 이 부분의 95% 이상을 자동화할 수 있다고 예상합니다. 이 수치는 회사·문서·권한 설계에 따라 크게 달라지는 조건부 추정입니다.
Claude Cowork의 예약 작업은 매일 메일·Slack·캘린더를 요약하거나, 매주 Drive 자료를 모아 보고서를 만드는 반복 업무를 제품 기능으로 끌어옵니다. 자동화의 단위가 “버튼을 누르는 일”에서 “매주 결과물을 납품하는 일”로 바뀌는 지점입니다.
산업의 다음 경쟁은 보안·거버넌스·판단이다
공공·법무·세무·부동산에서 일어날 변화
공공기관, 법무법인, 세무·회계, 부동산 컨설팅처럼 텍스트와 고급 정보를 많이 다루는 업종은 LLM의 이점을 크게 받을 수 있습니다. 과거 기록을 검색하고, 문서의 맥락을 비교하고, 신규 정책이나 의견서의 초안을 만들고, 정해진 양식으로 보고하는 업무가 많기 때문입니다. Microsoft AI Builder의 문서 처리 구조도 문서 수신·정보 추출·검토·결과 통보를 하나의 흐름으로 묶되, 예외는 사람이 확인하는 구조를 전제로 합니다.
다만 이런 조직은 외부 LLM을 바로 도입하기 어렵습니다. 개인정보·비공개 기록·법률상 비밀·국가 중요 정보가 포함될 수 있고, 누가 어떤 문서를 읽고 어떤 결정을 했는지 감사할 수 있어야 합니다. Cowork의 안전 가이드도 읽기 도구와 쓰기 도구의 위험이 다르고, 예약 작업·브라우저·커넥터가 서로 다른 서비스로 데이터를 전달할 수 있으므로 권한과 사람 검토를 맞춰야 한다고 설명합니다.
필자는 이 보안·법규제·감사 문제가 해결되는 조직에서는 현재 담당자가 수행하는 잡무의 상당 부분이 자동화될 것으로 봅니다. “담당자의 95%가 필요 없어진다”는 의미가 아니라, 현재 업무 시간의 95%를 차지하는 복사·검색·정리·문서화 중심의 반복 작업에서 해방되어 판단과 설계에 더 많은 시간을 쓰게 된다는 뜻입니다.
아이디어를 내는 사람과 문서를 만드는 사람의 역할이 갈라진다
과거 정책을 입안하거나 사업계획을 만들 때 담당자는 기록을 찾아 읽고, 여러 아이디어를 문서로 정리하고, 시안을 만들고, 보고서를 작성하느라 밤을 새우기도 했습니다. 앞으로는 과거 기록의 맥락을 찾아 비교하고, 여러 방향의 아이디어와 시안·보고서 초안을 만드는 일은 자동화될 가능성이 높습니다.
사람의 역할은 더 나은 방향성을 판단하고, 현실적인 제약을 반영하고, 결과물이 실제 현장에서 작동할지 검토하는 쪽으로 이동합니다. 즉, 아이디어가 없는 사람이 문서를 잘 만드는 능력보다, 많은 후보 중 어떤 방향을 선택할지 판단하고 빠르게 프로토타입을 검증하는 능력이 중요해집니다.
여기서 기존 RPA와 API가 사라지는 것은 아닙니다. 오히려 에이전트가 판단한 결과를 실제 시스템에 안전하게 반영하려면 API, 업무 규칙, 승인선, 감사 로그가 더 중요해집니다. 자동화 시장은 “LLM 하나로 끝내기”가 아니라 에이전트의 추론과 기존 시스템의 통제력을 결합하는 시장으로 재편될 가능성이 큽니다.
에이전트가 문서를 읽고 도구를 호출할 수 있다는 사실이 곧 업무를 무감독으로 맡겨도 된다는 뜻은 아닙니다. 문서 안의 악성 지시, 잘못된 권한, 오래된 데이터, API 오류, 환각이 실제 전송·삭제·정책 판단으로 이어질 수 있습니다. 민감한 업무는 읽기와 쓰기 권한을 나누고, 외부 전송과 최종 보고 전에 사람 승인 단계를 남겨야 합니다.
마무리
클로드가 산업지형을 바꾸는 핵심은 더 좋은 답변을 만드는 데 있지 않습니다.
Claude Code가 개발자의 파일·명령·도구 작업을 에이전트 루프로 묶었습니다.
Claude Cowork가 그 구조를 비개발자의 문서·파일·클라우드 업무로 확장했습니다.
RPA·API·문서 처리·협업 제품은 사라지기보다 에이전트를 안전하게 운영하는 오케스트레이션 계층으로 이동하고 있습니다.
정형 업무의 자동화율은 높아지지만, 방향성 판단·책임·보안·최종 승인까지 자동화되는 것은 아닙니다.
이미 발 빠른 회사들은 도구를 하나씩 추가하는 대신 업무 흐름 자체를 AI 중심으로 다시 설계하고 있습니다. 여러분의 회사는 지금 어떤 업무를 사람이 직접 복사하고, 검색하고, 정리하고, 보고서로 옮기고 있습니까? 그 작업의 목적과 권한을 먼저 정의할 수 있다면, 자동화는 생각보다 가까이 와 있을 수 있습니다.
다음에는 클로드를 이용해 이런 실무적인 자동화 기법을 어떻게 사용하는지 알아보겠습니다. 궁금한 분들은 기대해 주세요.
이 글은 맥 파인더 사용법을 처음 찾는 맥 파일 초보자를 위한 안내서입니다. Finder를 중심으로 한 맥 파일 관리의 기본 구조와 설정부터 차근차근 살펴보겠습니다.
Finder의 메뉴 위치와 폴더 역할은 공식 안내를 기준으로 설명하고, “어떤 설정이 더 편한가”에 대한 평가는 필자의 사용 경험을 바탕으로 합니다.
Finder는 맥의 파일 탐색기입니다
맥을 처음 켜고 파일을 찾으려면 가장 먼저 만나게 되는 앱이 Finder입니다. Finder는 문서, 사진, 다운로드한 파일, 설치된 앱, 외장 디스크처럼 맥 안의 거의 모든 항목을 보고 정리하는 기본 파일 관리자입니다. 윈도우의 파일 탐색기와 비슷한 역할을 한다고 생각하면 출발하기 쉽습니다.
다만 맥은 창 안에 프로그램 메뉴가 붙어 있지 않습니다. 현재 사용 중인 프로그램의 메뉴가 화면 최상단 메뉴 막대에 나타나는 방식입니다. Finder 창을 열어 놓고도 메뉴는 창의 위쪽이 아니라 화면의 가장 위에서 찾는다는 점을 먼저 기억해 두면 좋습니다.
저는 윈도우보다 맥의 사용성이 낫다고 느끼는 부분 중 하나로 Finder를 꼽습니다. 폴더를 열고, 현재 위치를 확인하고, 여러 작업을 탭으로 묶는 흐름이 제 작업 방식에는 자연스럽게 맞았습니다. 다만 이것은 객관적인 운영체제 우열이라기보다 오랫동안 사용하며 생긴 개인적인 사용성 의견입니다.
Dock에서 파란색 웃는 얼굴 모양의 Finder 아이콘을 클릭하면 Finder 창이 열립니다. Apple도 Finder를 맥에서 문서와 폴더를 정리하고 접근하는 기본 공간으로 설명합니다. Finder의 기본 역할과 화면 구성은 Apple 공식 안내에서도 확인할 수 있습니다.
먼저 맞춰 둘 Finder 기본 설정
처음부터 모든 설정을 바꿀 필요는 없습니다. 저는 파일의 위치와 현재 상태를 놓치지 않는 데 도움이 되는 항목만 먼저 켜고, 사이드바와 태그는 자주 쓰는 것만 남겨 두는 편입니다.
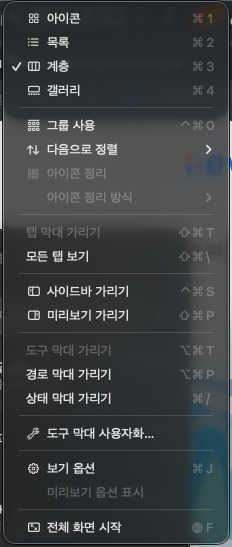
보기 메뉴에서 세 가지 막대 보이기
Finder 창을 활성화한 뒤 화면 최상단 메뉴 막대에서 보기를 엽니다. 여기서 다음 세 항목을 켭니다.
도구 막대 보기
경로 막대 보기
상태 막대 보기
도구 막대는 뒤로 가기, 보기 방식 변경, 공유와 같은 조작 버튼이 모이는 영역입니다. 경로 막대는 현재 폴더가 어떤 상위 폴더 안에 있는지 보여 주고, 상태 막대는 현재 폴더의 항목 수와 저장 공간 상태를 보여 줍니다. Finder 도구 막대는 Apple 공식 안내처럼 필요한 버튼을 추가하거나 순서를 바꿀 수도 있습니다.
세 막대를 모두 켜 두면 “지금 어디에 있는 파일인지”, “현재 폴더에 무엇이 얼마나 있는지”, “어떤 조작을 할 수 있는지”를 한 화면에서 확인하기 쉬워집니다. 화면이 좁아 보인다면 나중에 도구 막대만 정리하면 됩니다.
<Finder 보기 메뉴의 표시 항목 2.1>
Finder 설정에서 일반·사이드바·태그 정리
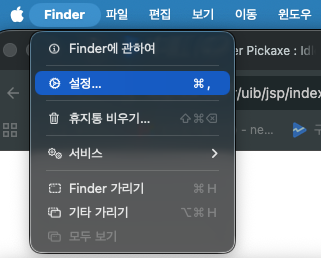
Finder를 클릭해 활성화한 상태에서 화면 위쪽의 Finder > 설정을 엽니다. 설정 화면은 macOS 버전에 따라 표현이 조금 다를 수 있지만, 다음 세 곳을 먼저 보면 됩니다.
<Finder 설정 메뉴 진입 2.2>
일반에서는 새 Finder 창을 열었을 때 처음 표시할 위치를 정할 수 있습니다. Finder를 열 때마다 최근 항목보다 홈, 문서, 다운로드처럼 자신이 자주 쓰는 위치가 먼저 보이는 편이 편하다면 이곳에서 바꿔 보세요.
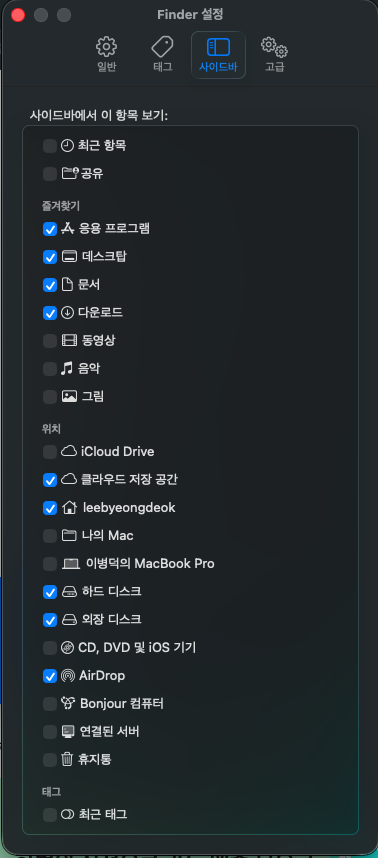
사이드바에서는 Finder 왼쪽에 표시할 항목을 정합니다. 응용 프로그램, 데스크탑, 문서, 다운로드, 홈, 내장 디스크처럼 실제로 자주 쓰는 항목만 남기면 왼쪽 목록이 덜 복잡해집니다. Finder 설정의 사이드바 항목은 Apple 공식 문서에서도 확인할 수 있습니다.
<Finder 사이드바 설정 2.3>
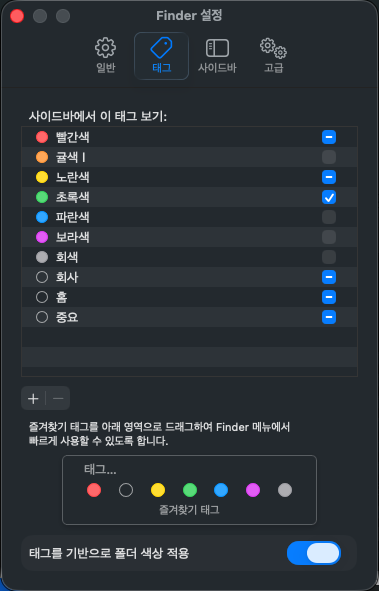
태그에서는 파일이나 폴더에 붙일 색상 태그와 사이드바에 보일 태그를 정합니다. 모든 색상을 한꺼번에 노출하면 오히려 목록이 복잡해질 수 있으니, 처음에는 빨강·주황처럼 한두 가지 색상만 남겨 두는 것을 권합니다. 태그는 폴더를 대신하는 저장 장소가 아니라, 서로 다른 폴더에 있는 파일을 가로로 묶어 찾는 보조 분류입니다.
<Finder 태그 설정 2.4>
데스크탑·문서 폴더 동기화는 iCloud에서 설정
데스크탑과 문서 폴더를 다른 Apple 기기에서도 사용하고 싶다면 Apple 메뉴 > 시스템 설정 > [사용자 이름] > iCloud > Drive(iCloud Drive) > 이 Mac 동기화 > 데스크탑 및 문서 폴더에서 설정합니다. macOS 버전에 따라 iCloud Drive가 Drive로 표시될 수 있습니다.
이 기능을 켜면 데스크탑과 문서 폴더가 iCloud Drive에 저장되고, 같은 Apple 계정으로 로그인한 다른 기기에서도 접근할 수 있습니다. 반대로 한 기기에서 파일을 삭제하면 다른 기기에서도 삭제될 수 있으므로 iCloud 동기화를 백업과 같은 것으로 생각하면 안 됩니다.
또한 iCloud Drive의 저장 공간을 사용합니다. 저장 공간이 부족하거나 여러 클라우드 서비스가 동시에 데스크탑·문서 폴더를 관리하면 예상하지 못한 동기화 문제가 생길 수 있으므로, 처음에는 한 가지 동기화 방식을 선택하는 편이 안전합니다. 데스크탑과 문서 폴더를 iCloud Drive에 추가하는 방법은 Apple 안내를 참고할 수 있습니다.
iCloud 동기화는 백업이 아닙니다. 중요한 파일은 별도의 백업을 준비하고, 동기화를 켜기 전에 iCloud 저장 공간과 다른 클라우드 앱의 동기화 설정을 확인하세요.
Finder 창의 화면 구성과 탭 사용법
폴더를 한눈에 보는 열 보기
Finder 창 오른쪽 위에는 파일과 폴더를 표시하는 방식이 있습니다. 대표적으로 아이콘 보기, 목록 보기, 열 보기, 갤러리 보기를 사용할 수 있습니다. 저는 폴더 구조를 확인할 때 열 보기(Column View)를 기본으로 사용합니다.
<Finder 보기 방식 버튼 3.1>
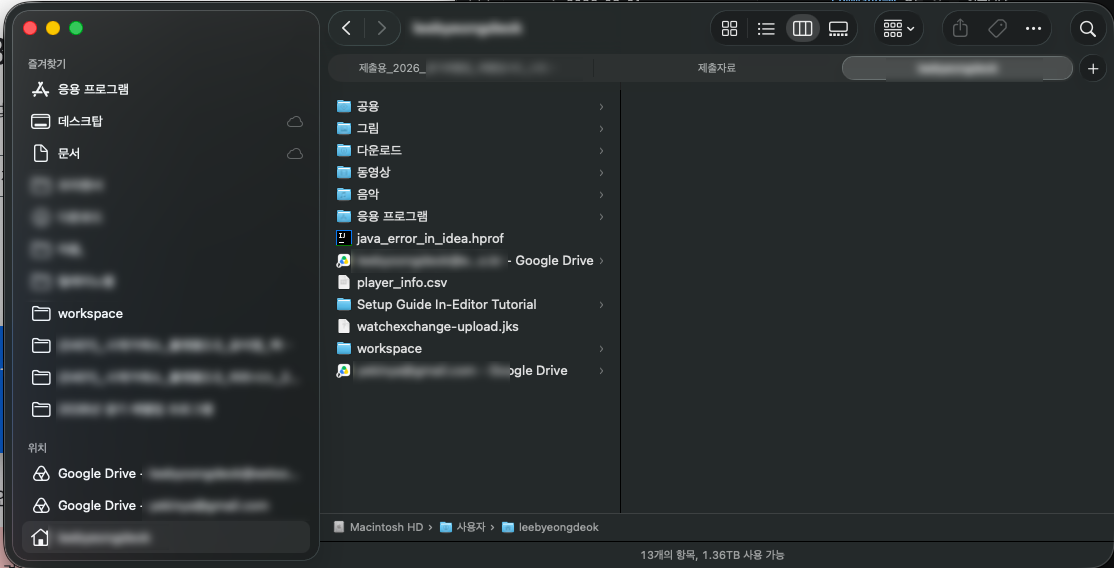
열 보기에서는 왼쪽에서 상위 폴더를 선택하면 오른쪽 열에 그 안의 하위 폴더가 이어집니다. 다시 하위 폴더를 선택하면 그 안쪽이 한 칸 더 오른쪽에 나타납니다. 그래서 지금 보고 있는 파일이 어떤 폴더 안에 있는지, 상위에 어떤 폴더가 있는지를 한눈에 확인할 수 있습니다.
<Finder 열 보기와 경로 막대 3.2>
각 폴더의 보기 방식은 보기 > 보기 옵션 보기 또는 Command-J에서 조절할 수 있습니다. 아이콘 크기, 정렬 방식, 표시할 정보 등을 바꿀 수 있지만, 이번 편에서는 네 가지 보기의 차이와 열 보기의 장점만 익혀도 충분합니다. Finder 보기 방식과 보기 옵션은 Apple 공식 안내에 정리되어 있습니다.
새 창과 새 탭 사용하기
Finder의 기본 동작은 새 창으로 여는 방식입니다. 특정 폴더를 지정하지 않은 새 Finder 창은 Command-N으로 열 수 있습니다.
폴더와 문서를 새 탭으로 열고 싶다면 시스템 설정 > 데스크탑 및 Dock > 윈도우 > 문서를 열 때 탭 사용 > 항상으로 설정합니다. 이 옵션을 켜면 폴더를 열 때 창이 계속 늘어나는 대신 기존 Finder 창 안의 새 탭으로 열리는 흐름을 사용할 수 있습니다.
탭은 + 버튼이나 Command-T로 추가할 수 있습니다. 여러 탭을 한 창에 모아 두면 업무, 개인, 자료처럼 작업 영역을 나누어 오갈 때 편합니다. 반대로 한 탭을 별도 창으로 보고 싶다면 탭을 잡고 창 밖으로 끌어내면 됩니다. 폴더를 탭이나 새 창으로 여는 방식은 Apple 공식 안내에서도 확인할 수 있습니다.
왼쪽 사이드바의 기본 영역
Finder 왼쪽에는 자주 사용하는 위치가 모여 있습니다. 이 목록을 폴더 그 자체라고 생각하기보다, 해당 위치로 빠르게 이동하는 바로가기 목록이라고 생각하면 이해하기 쉽습니다.
응용 프로그램: 맥에 설치된 앱이 모여 있는 기본 위치입니다. Dock에서 앱 아이콘을 빼는 것과 응용 프로그램을 삭제하는 것은 다릅니다.
데스크탑: 화면에 보이는 바탕화면 파일과 연결되는 위치입니다. 데스크탑·문서 동기화를 켜면 iCloud Drive 안의 데스크탑과 연결될 수 있습니다.
문서: 홈 폴더 안에 macOS가 기본으로 마련해 둔 문서 위치입니다. iCloud 동기화를 켜면 iCloud Drive에 보관될 수 있습니다.
다운로드: 웹 브라우저나 파일 공유 앱이 받은 파일을 저장하는 기본 위치로 자주 사용됩니다. Chrome처럼 앱의 설정에서 저장 위치를 바꿀 수 있으므로 모든 파일이 항상 이곳에 저장되는 것은 아닙니다.
홈: 로그인한 사용자 개인의 파일과 기본 폴더가 모여 있는 위치입니다.
내장 디스크: 맥의 시작 디스크와 시스템의 최상위 위치를 확인하는 곳입니다.
자주 쓰는 폴더는 Finder 창에서 사이드바의 즐겨찾기 영역으로 직접 드래그해 바로가기로 추가할 수 있습니다. 이때 폴더가 이동하는 것이 아니라 원래 위치에 그대로 남고, 사이드바에는 빠르게 열 수 있는 연결 항목만 생깁니다. 필요 없어지면 사이드바 밖으로 끌어내어 제거할 수 있습니다.
폴더·경로·위치의 기본 개념
폴더는 다단계 바구니이자 주소 체계
비전문가라면 폴더를 파일을 관리하기 위한 “다단계 바구니”라고 생각해도 좋습니다. 큰 바구니 안에 작은 바구니를 넣을 수 있듯이, 폴더 안에는 하위 폴더와 파일을 넣을 수 있습니다.
예를 들어 프로젝트 폴더 안에 문서, 사진, 백업 폴더를 만들고, 그 안에 각각의 파일을 넣을 수 있습니다. 폴더를 잘 나누면 파일을 찾을 때 파일 이름만 기억하는 것이 아니라 “어느 바구니 안에 넣었는가”를 기준으로 찾을 수 있습니다.
이때 경로는 파일을 찾아가는 주소입니다. Macintosh HD > 사용자(Users) > 내 계정(홈 폴더) > 문서 > 프로젝트처럼 왼쪽에서 오른쪽으로 이동하면 더 깊은 폴더로 들어갑니다. Finder의 경로 막대를 켜 두면 지금 보고 있는 위치를 확인하고, 상위 폴더로 바로 이동할 수 있습니다. 경로 막대의 폴더를 Control-클릭하면 해당 위치의 경로를 복사할 수도 있습니다. 파일·폴더·디스크 정보와 경로 막대는 Apple 안내를 참고하세요.
Macintosh HD·사용자·홈 폴더
Finder의 내장 디스크 아래에서 보이는 Macintosh HD는 맥의 시작 디스크 이름입니다. 터미널에서 사용하는 최상위 경로인 루트(/)를 설명할 때 이 위치와 연결해 이해하면 쉽습니다.
그 안의 사용자(Users) 폴더에는 이 맥을 사용하는 사람들의 홈 폴더가 있습니다. 사용자(Users) > 내 계정 이름으로 들어가면 로그인한 사용자의 홈 폴더가 나오고, 그 안에 데스크탑, 문서, 다운로드, 사진, 음악, 동영상 같은 개인 파일 위치가 있습니다.
System과 Library 같은 폴더는 macOS와 앱이 사용하는 영역입니다. 이름을 바꾸거나 다른 곳으로 옮기면 운영체제나 앱이 정상적으로 동작하지 않을 수 있으므로, 초보자라면 개인 파일을 홈 폴더 안에서 관리하는 편이 안전합니다. Apple도 맥에 기본으로 제공되는 폴더 중 일부는 이름을 바꾸거나 이동하지 않는 것이 좋다고 안내합니다. macOS 기본 폴더의 역할은 Apple 공식 문서에서 확인할 수 있습니다.
파일이 실제로 저장되는 방식
폴더 트리는 단순히 사람이 보기 좋은 그림만은 아닙니다. macOS의 파일 시스템은 파일명, 폴더, 권한, 메타데이터를 디렉터리 구조로 관리하고, 파일 내용은 저장 장치의 영역과 연결합니다. 따라서 Finder에 보이는 폴더 구조는 파일 시스템이 관리하는 실제 논리 구조입니다.
다만 화면에서 보이는 폴더 구조와 파일 내용이 디스크에 저장되는 물리적인 위치가 언제나 일대일로 같은 것은 아닙니다. 파일 내용은 저장 장치의 여러 영역에 나뉘어 보관될 수 있지만, 운영체제가 파일 시스템의 정보를 이용해 하나의 파일처럼 보여 줍니다.
초보자에게는 “폴더는 파일 이름과 위치를 기록한 주소 체계이고, 실제 파일 내용은 저장 장치에 보관된다”고 설명하면 충분합니다. APFS의 세부 자료구조까지 이해해야 Finder를 사용할 수 있는 것은 아닙니다.
AirDrop은 폴더가 아니라 전송 화면
Finder 사이드바에 있는 AirDrop은 폴더가 아닙니다. 맥, 아이폰, 아이패드처럼 가까이에 있는 Apple 기기를 찾아 파일을 보내고 받는 무선 전송 화면입니다.
AirDrop 창에 상대방 기기가 나타나면 파일을 그 기기 위로 끌어 보내고, 받은 사람은 수락 여부를 선택합니다. 받은 파일은 파일의 종류와 수신 동작에 따라 다운로드 폴더 등에 저장될 수 있으므로, AirDrop 자체에 파일이 계속 쌓인다고 생각하면 안 됩니다. AirDrop의 전송 방식은 Apple 공식 안내에서 확인할 수 있습니다.
Wi-Fi와 Bluetooth가 켜져 있어야 하고, 기기 사이의 거리와 수신 허용 범위도 영향을 줍니다. AirDrop은 다음 편에서 실제 파일을 보내고 받는 순서와 수신 설정을 따로 다루겠습니다.
마무리
이번 편에서 기억할 내용은 네 가지입니다.
Finder는 맥의 파일 탐색기이며, 메뉴는 창 안이 아니라 화면 최상단에 있습니다.
도구 막대, 경로 막대, 상태 막대를 켜면 파일을 조작하고 현재 위치와 상태를 확인하기 쉬워집니다.
열 보기, 탭, 사이드바 바로가기를 조합하면 폴더 구조를 한눈에 보고 자주 쓰는 위치로 빠르게 이동할 수 있습니다.
iCloud는 동기화 기능이고 AirDrop은 전송 화면이며, 둘 다 일반 폴더와는 다른 개념입니다.
다음 편에서는 Finder에서 파일 확장자를 확인하는 방법, Quick Look으로 파일을 빠르게 미리 보는 방법, 압축 파일과 앱 삭제, 스크린샷 저장 위치를 이어서 살펴보겠습니다.
AI 모델을 고를 때 7B, 14B, 70B 같은 숫자를 자주 봅니다. 이 숫자는 모델이 학습한 파라미터(parameter)의 개수입니다. 숫자가 크면 보통 더 많은 패턴과 지식을 표현할 여지가 있지만, 답변 품질·속도·메모리가 숫자 하나로 결정되지는 않습니다. AI 서버의 GPU 병목과 GPU 클라우드 비용을 함께 보면 이 숫자가 왜 인프라 비용으로 이어지는지도 이해하기 쉽습니다.
파라미터와 가중치는 무엇인가
신경망은 입력을 다음 층으로 전달하면서 수많은 곱셈과 덧셈을 합니다. 이때 학습으로 조정되는 숫자가 파라미터입니다. 가중치(weight)는 연결마다 곱해지는 핵심 파라미터를 가리키는 말이고, 편향·임베딩·정규화 값 등도 넓은 의미의 파라미터에 포함됩니다. 일상적인 설명에서는 두 단어를 거의 같은 뜻으로 쓰지만 완전히 같은 개념은 아닙니다.
모델의 “크기”는 대개 파라미터 수로 말합니다. 하지만 실행에 필요한 메모리는 파라미터 수 × 숫자 정밀도로 먼저 계산해야 합니다.
저장 형식
파라미터 1개에 필요한 대략적인 메모리
70B 가중치만 계산한 값
FP16/BF16
2바이트
약 140GB
INT8
1바이트
약 70GB
4비트 양자화
0.5바이트
약 35GB
실제 VRAM에는 가중치 외에도 KV 캐시(긴 대화 기억), 실행 버퍼, 프레임워크 오버헤드와 여유 공간이 필요합니다. 그래서 “70B가 4비트면 35GB”는 하한선이지 35GB GPU에서 항상 쾌적하다는 뜻이 아닙니다. 컨텍스트 길이와 동시 사용자 수가 늘면 필요한 메모리도 커집니다.
필자의 부족한 지식으로 예를 들자면 파라미터는 인간의 뇌의 용량(연결된 뉴런의 갯수라고 표현해야 할까요?), 가중치는 학습시 우선시 학습하는 카테고리 정도로 이해하면 편할 듯합니다.
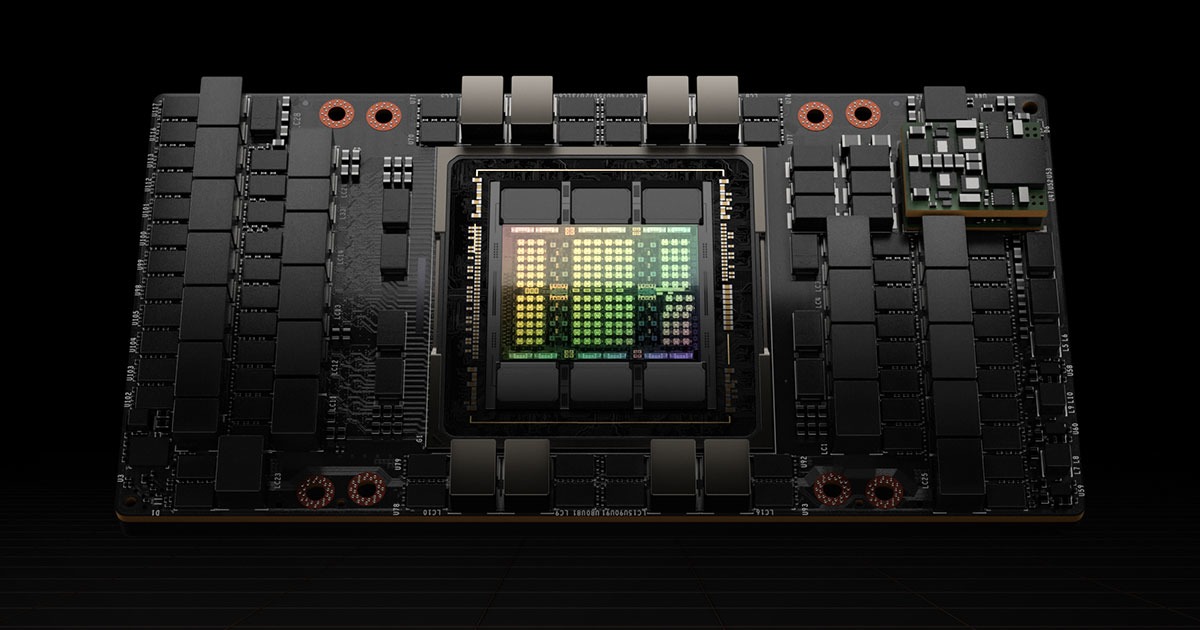
<NVIDIA H100 공식 이미지. H100 제품 사양은 80GB HBM3 메모리와 94GB H100 NVL을 구분해 제시합니다. 출처: NVIDIA>
파라미터 크기별 현실적인 실행선
아래 표는 “모델을 띄울 수 있느냐”를 가중치 메모리와 일반적인 추론 여유 공간을 기준으로 보수적으로 나눈 것입니다. 양자화 방식, 컨텍스트, CUDA·Metal 커널, 모델 구조에 따라 결과가 달라지므로 절대적인 컷오프가 아닙니다.
하드웨어
실사용을 기대할 수 있는 범위
해석
RTX 5090 32GB
7B14B는 편안함, 20B27B는 4비트 중심
30B 이상은 저컨텍스트·오프로딩 없이는 부담
H100 80GB 1장
30B 전후 BF16, 70B 4비트
40B BF16은 가중치만 약 80GB라 실사용 여유가 없음
H100 80GB 4장
70B BF16은 충분, 100B~120B는 배치·컨텍스트에 따라 가능
150B 이상은 설계와 메모리 분할을 따져야 함
H100 80GB 4장, 300B급
일반적인 Dense BF16은 불가
300B는 BF16 가중치만 약 600GB. MoE도 전체 가중치는 저장해야 함
NVIDIA도 H100 NVL을 Llama 2 70B용으로 소개하며 188GB HBM 구성을 제시합니다. 이 자료는 “70B는 80GB 한 장에 BF16으로 넉넉히 들어간다”는 식의 주장을 반박하는 실제 제품 사례입니다. 70B 4비트는 한 장에서 가능할 수 있지만, BF16 70B는 H100 NVL처럼 메모리를 합친 구성이 더 자연스럽습니다.
RTX 5090은 32GB GDDR7이라 개인용 양자화 모델의 현실적인 상한을 넓혀줍니다. 다만 14B와 30B의 체감 속도 차이는 모델 파일 크기뿐 아니라 메모리 대역폭과 커널 최적화에도 좌우됩니다. 서버에서는 GPU 여러 장의 VRAM을 단순히 더하는 것만으로 끝나지 않고, NVLink·PCIe 통신과 텐서 병렬화 비용이 생깁니다.
M4 맥북에서 돌려볼 만한 오픈 웨이트 모델
필자가 사용하는 M4 맥북 프로 48GB 통합 메모리에서는 운영체제와 앱이 메모리를 함께 사용합니다. 따라서 48GB 전부를 모델에 할당할 수 없습니다.
20B~32B 4비트: 실행은 가능할 수 있지만 긴 컨텍스트와 빠른 응답을 동시에 기대하기 어렵습니다. 코딩·추론용은 같은 크기라도 양자화 품질을 확인해야 합니다.
70B 4비트: 48GB 맥북에서는 파일 크기와 런타임 여유를 생각하면 일반적인 추천이 아닙니다. 128GB 통합 메모리 상위 맥이라도 노트북다운 속도와 안정성을 보장하지 않습니다.
설치 방법은 Ollama, LM Studio, MLX가 진입장벽이 낮습니다. 맥북 로컬 AI의 장점은 최고 성능보다 개인 문서가 외부 서버로 나가지 않는 통제력과 낮은 진입비용에 있습니다. M4 세대의 통합 메모리 구성은 Apple의 MacBook Pro 사양에서 확인할 수 있습니다.
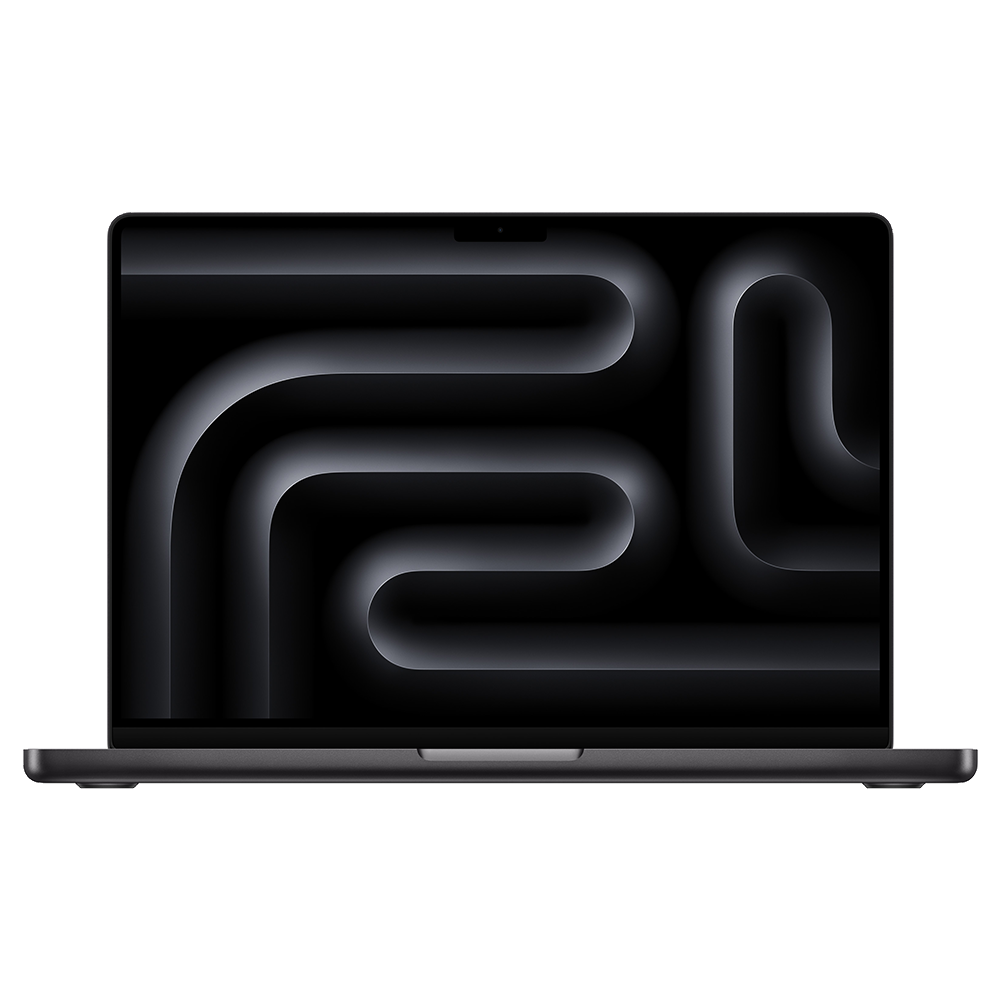
<MacBook Pro M4 공식 제품 이미지. 통합 메모리는 CPU와 GPU가 공유하므로 모델에 전부 사용할 수 없습니다. 출처: Apple>
GPU 가격은 왜 체감이 다른가
2026년 8월 초 확인 가능한 공개 자료를 보면 소비자 GPU와 데이터센터 GPU의 가격 체계가 완전히 다릅니다.
파라미터 수는 모델의 잠재적인 표현 용량을 보여주지만, 실제 사용성은 정밀도·양자화·컨텍스트·메모리 대역폭·소프트웨어 최적화까지 합쳐서 결정됩니다. 지금은 M4 48GB에서 8B~14B 모델 정도가 한계로 보입니다. 그래도 이정도로 집에서 돌려볼 수 있게된 현실게 감사할 따름이죠. H100 1장은 70B 양자화, H100 4장은 70B BF16부터 현실성이 높아집니다. 뭐 그래도 일반인들이 집에서 돌리기에는 무리가 있죠.
나의 한줄은 이렇습니다. 어서 빨리 내 집 컴퓨터에 개인용 모델을 설치하고, 나만 사용하는 AI 에이전트를 쓰고 싶다. 아마 미래는 모델이 더 작아지고 지능형 그래픽카드가 더 좋아지는 방향으로 발전할 것입니다. 이미 그런시대가 코앞에 와있을지 모를 일이죠. AI의 발전을 보고 있으면 매일매일을 기대하게 됩니다.
모티프 3 Beta는 작은 국내 스타트업이 GPU 수보다 설계와 인프라 효율성으로 어디까지 올라갈 수 있는지를 보여주는 실험입니다. AI 서버의 GPU 병목을 함께 살펴보면 이 모델의 희소 연산 설계가 왜 중요한지 이해하기 쉽습니다. 다만 아직 최종 모델이 아닌 베타이며, 기업용 상업 라이선스와 공개 학습 데이터 정보가 제한되어 있습니다.
<모티프테크놀로지스 공식 로고, 출처 Motif Technologies 1.1>
모티프테크놀로지스는 어떤 회사인가
모티프테크놀로지스는 인공지능 인프라 기업 모레의 AI 사업 조직에서 출발해 2025년 2월 설립된 서울 소재 스타트업입니다. 모레가 GPU 클러스터 최적화, 분산 추론과 경량화에 집중하고 모티프가 모델 설계와 생성형 AI 제품 개발에 집중하는 구조입니다. 회사 공식 소개는 모티프를 단순한 챗봇 회사가 아니라 모델·인프라·기업용 AX를 함께 다루는 회사로 설명합니다.
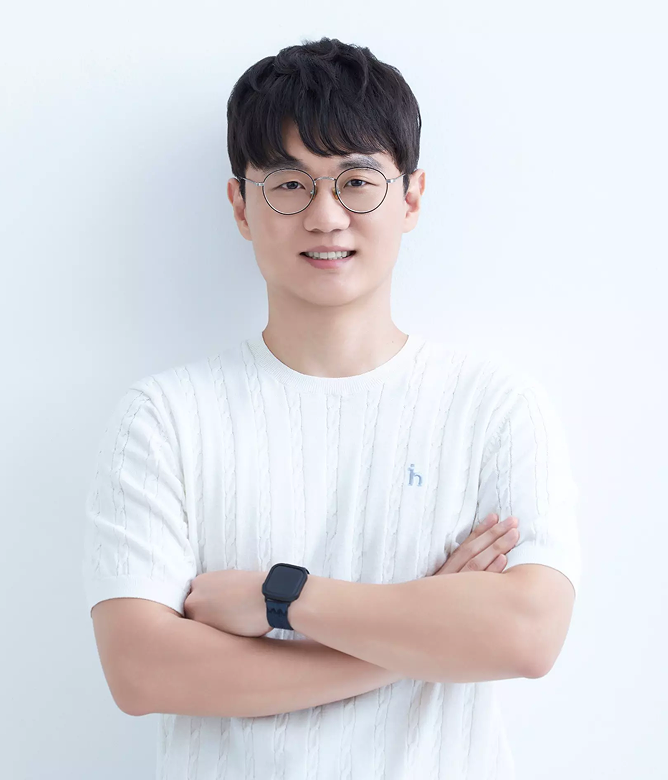
대표는 임정환 CEO입니다. 회사 공식 프로필에 따르면 임 대표는 KAIST 학사와 영국 옥스퍼드대학교 박사 학위를 받았고, PUBG와 삼성 리서치에서 데이터 사이언티스트로 일한 뒤 모레에서 AI 디렉터를 맡았습니다. 즉 “국내 대학 출신 창업자”라는 한 줄보다, 수학·연구·게임 데이터·GPU 인프라를 함께 경험한 이력이 모티프의 방향을 설명하는 데 더 중요합니다.
공개 기업정보를 종합하면 2026년 6월 기준 임직원은 약 30명이며, 모티프는 비상장 스타트업입니다. 기업공개를 한 대기업과 비교할 규모는 아니지만, 314B급 모델을 공개한 조직으로서는 매우 작은 편입니다. 2025년 중반 보도에서는 25명 미만으로 소개됐으므로 인력 수는 시점에 따라 변하는 추정치로 읽어야 합니다. THE VC 기업정보도 모티프를 2025년 설립 스타트업, 대표 임정환, 비상장 기업으로 분류합니다.
<모티프테크놀로지스 임정환 대표, 출처 Motif Technologies 2.1>
Motif-3-Beta의 핵심은 거대한 MoE와 작은 활성 연산량이다
현재 공개된 Motif-3-Beta 모델 카드의 핵심 수치는 총 약 3,140억 개 파라미터, 토큰당 약 130억 개 활성 파라미터, 256K 토큰 컨텍스트입니다. 전체 모델을 매번 모두 계산하는 Dense 모델이 아니라 384개 라우팅 전문가 중 8개와 공유 전문가 1개를 선택하는 Mixture-of-Experts(MoE) 구조입니다.
항목
공개 정보
의미
총 파라미터
약 314B
모델 전체 지식 용량과 저장 규모
활성 파라미터
토큰당 약 13B
한 토큰을 처리할 때 실제로 선택되는 연산 규모
전문가 구조
라우팅 384개 중 Top-8 + 공유 전문가 1개
입력마다 다른 전문가를 선택하는 희소 연산
컨텍스트
256K 토큰
긴 문서·코드 저장소를 한 번에 넣을 수 있는 설계 목표
레이어·히든 크기
53층·4096
모델 카드에 공개된 기본 구조 정보
정밀도
bfloat16
학습·추론용 수치 형식
모티프가 강조하는 특이점은 기존 오픈소스 모델의 파라미터를 다시 포장한 모델이 아니라 자체 설계를 출발점으로 삼았다는 점입니다. 모델 카드에는 Grouped Differential Latent Attention(GDLA), 전문가별 Grouped PolyNorm, 수정된 mHC, Multi-Token Prediction 헤드가 적혀 있습니다. MTP 헤드는 다음 토큰을 미리 예측해 자기 speculative decoding을 가능하게 하는 구성입니다.
이 설명은 “314B니까 무조건 GPT-4급”이라는 뜻이 아닙니다. MoE는 총 용량과 한 번의 계산량을 분리해 비용을 줄이는 방법이지만, 전문가 라우팅·메모리 이동·병렬화가 잘못되면 실제 운영비와 지연시간이 커질 수 있습니다. 13B 활성 파라미터는 흥미로운 숫자지만, GPU 메모리에는 전체 가중치와 통신 경로가 영향을 줍니다.
<Motif-3-Beta 공식 모델 카드 이미지, 출처 Hugging Face의 Motif Technologies 저장소 3.1>
성능은 높지만 실사용 레벨은 물음표
Motif-3-Beta 모델 카드에는 Artificial Analysis Intelligence Index(AAII) 44점이 제시되어 있습니다. 외부 평가 페이지는 이 점수를 여러 언어 모델의 지식·추론·수학·코딩을 합친 종합 지표로 보여주지만, 순위는 평가 시점과 모델 표본에 따라 변합니다. 따라서 “국산 모델 최초 세계 3위”라는 표현보다 “공개된 베타 모델이 AAII 44점을 기록했다”가 더 맞는 표현입니다.
더 중요한 한계도 있습니다. 모델 카드에는 Motif-3 자체의 KMMLU, HumanEval, MBPP, SWE-bench 점수가 체계적으로 공개되어 있지 않습니다. 이전 세대 Motif 2.6B는 모델 카드에서 HumanEval 68.3, MBPP 60.3을 제시했지만, 그 숫자를 Motif-3의 코딩 성능으로 옮겨 적을 수는 없습니다. 모델 크기가 커졌다고 개인적으로 필자가 관심있는 코딩 에이전트 성능이 자동으로 보장되는 것도 아닙니다.
모티프 3은 일반 목적의 다국어 텍스트 생성 모델에 가깝고, 현재 공개 베타는 이미지 입력을 지원하지 않습니다. 로컬에서 vLLM 또는 SGLang으로 OpenAI 호환 채팅 엔드포인트를 띄울 수 있지만, 모델 카드가 테스트 환경으로 명시한 GPU가 B200·H200이라는 점은 개인 개발자에게 현실적인 진입 장벽입니다. 256K 컨텍스트는 저장소 전체를 성능지표로 이해하는 데 유리할 수 있지만, 근래의 외산 AI들의 LLM, 이미지, 추론, 디자인 등의 괴물같은 성능을 보면 갈길이 멀어 보이기도 합니다.
무료인가, 유료인가, API가 있는가
Motif-3-Beta 가중치는 Hugging Face에서 접근 요청 없이 내려받을 수 있습니다. 그러나 현재 모델 카드의 라이선스는 개인·교육·비상업 연구 목적의 사용·수정·재배포만 허용하며, 상업적 사용은 모티프의 사전 서면 허가가 필요합니다. 따라서 “오픈 웨이트”와 “상업적으로 자유로운 오픈소스”를 같은 말로 사용하면 안 됩니다.
모티프의 공식 Open API 페이지는 현재 Motif 12.7B Reasoning API를 OpenAI Chat Completions 방식으로 호출할 수 있다고 안내합니다. 하지만 이 페이지가 Motif-3-Beta의 공개 상용 API 가격표나 모델별 과금표를 제공하는 것은 아닙니다. 정리하면 다음과 같습니다.
사용 방식
현재 확인되는 상태
Motif-3-Beta 가중치
다운로드 가능, 비상업 연구 라이선스
Motif-3-Beta 호스팅 API
공개 가격·상용 제공 여부를 확인하지 못함
Motif 12.7B Reasoning API
공식 Open API에서 키 발급·호출 방식 안내
로컬 API
vLLM·SGLang으로 OpenAI 호환 서버 구성 가능
기업이 실제 서비스에 넣으려면 모델 다운로드보다 라이선스 협의, GPU 비용, 장애 대응, 데이터 보안과 지원 계약이 더 중요합니다. 특히 베타 모델을 고객 데이터에 바로 연결하기보다 별도 평가 환경에서 품질·로그·삭제 정책을 검증해야 합니다. 필자는 이런 조건이 좀 많이 아쉽게 느껴집니다. 실 업무에 광범위하게 AI를 도입하고 있는 기업의 의사결정권자로서 AI는 기업환경에서 완벽하게 성능지표로 선택하는 도구입니다. 그렇기 때문에 가성비를 보면서도 성능을 최우선으로 봅니다. 결국 현재 강력한 외산의 AI도구와 비교했을때 거의 구글,오픈AI,클로드 외에 국산을 사용할 매리트가 없기 때문이죠. 응원만으로 생산성을 포기할 수없는게 기업입니다. 이렇게 승자독식의 AI세계에서 폐쇠적인 정책이 도움이 될지 모르겠습니다. 어차피 어지간한 중소기업은 돌릴용기도 없을 것입니다. 중국산들도 그렇기에 오픈으로 계속 여는 것이겠지요.
학습 데이터는 무엇이며 얼마나 투명한가
여기서는 공개된 것과 공개되지 않은 것을 구분해야 합니다. 공식 Motif-3-Beta 모델 카드에는 자체 설계, 파라미터·구조·컨텍스트 정보는 있지만, 학습에 사용한 원천 데이터셋 목록·저작권 정리·언어별 토큰 분포·필터링 절차를 상세히 공개하지 않습니다. 따라서 “어떤 웹사이트와 책을 학습했다”고 단정할 근거는 현재 부족합니다. 물론 다른 오픈 모델들도 마찬가지긴 합니다. 기업의 노하우와도 직결되니까요.
반면 이전 Motif 2.6B 모델 카드에는 AMD MI250 384장, 42일, 2.4T 토큰 학습이라는 정보가 공개돼 있습니다. 이 수치는 Motif-3의 학습량이 아니라 이전 모델의 기록입니다. Motif-3에 대해서는 정부 사업과 외부 보도에서 한국어 데이터와 대규모 학습 자원이 언급되지만, 최종 판단은 향후 기술보고서와 데이터 거버넌스 공개를 기다려야 합니다.
이 부분은 국산 AI의 경쟁력과도 연결됩니다. 한국어 데이터가 많다는 것만으로 좋은 모델이 되지 않습니다. 뉴스·웹·공공문서·코드·대화 데이터를 어떤 권리로 확보했는지, 중복·오염·개인정보를 어떻게 제거했는지, 평가 세트가 학습에 섞이지 않았는지가 장기 신뢰성을 좌우합니다.
GPU는 어떻게 확보했나: 투자보다 독파모 인프라가 큰 역할을 했다
모티프의 초기 강점은 AMD GPU를 활용했다는 것입니다. 이전 Motif 2.6B는 공식 모델 카드상 AMD Instinct MI250 384장으로 42일 동안 학습됐고, 모티프 측은 작은 모델을 AMD GPU 한 장에서도 추론할 수 있도록 만드는 비용 효율성을 강조했습니다. 이는 특정 GPU 공급사에 모델 개발 전체를 종속시키지 않으려는 모레의 인프라 소프트웨어 경험과 맞닿아 있습니다.
Motif-3-Beta는 맥락이 다릅니다. 모티프는 정부의 독자 AI 파운데이션 모델 사업(독파모) 정예팀으로 추가 선정됐고, 보도에 따르면 직원 약 30명이 정부 제공 GPU 700여 장을 활용해 약 5개월 만에 프리뷰 모델을 완성했습니다. 컨소시엄에서는 모티프가 모델 설계를 총괄하고 모레가 GPU 클러스터 최적화·분산 추론·경량화를 담당합니다.
공개 자료에서 확인되는 국책 지원은 GPU 자원과 독파모 개발·평가 체계이며, 세부 현금 지원액과 GPU 소유권은 명확히 공개되지 않았습니다. 투자 측면에서는 2026년 보도에 포레스트벤처스 50억 원과 다른 기관 100억 원 등 투자 내용이 언급됐고, 총 240억 원 규모 투자 유치와 기업가치 약 1,300억 원이라는 보도도 있습니다. 세부 금액의 공개 범위가 서로 다르므로 “240억 원 투자 유치 보도”로 표현하는 것이 정확합니다. 딜사이트 보도
<모티프 AI 모델 제품군 공식 이미지, 출처 Motif Technologies 4.1>
앞으로의 목표: 모델 하나가 아니라 산업용 AI 생태계
모티프가 공개적으로 제시하는 목표는 세 갈래입니다. 첫째, 언어 모델을 이미지·비디오 생성으로 확장하는 멀티모달 전략입니다. 둘째, 멀티모달을 로봇과 자율 작업으로 연결하는 피지컬 AI입니다. 셋째, 개발된 모델과 소프트웨어를 상업용 오픈소스와 대국민 AI 서비스로 개방해 산업·공공 AX 사례를 만드는 것입니다. 이는 AI GPU 클라우드의 비용 구조와도 맞닿아 있는 현실적인 과제입니다.
이 목표는 회사 규모를 생각하면 야심차지만, 모티프가 단순 모델 연구소가 아니라 모레와 함께 GPU 최적화·기업용 AX를 병행하는 이유이기도 합니다. 모델 판매만으로는 대규모 GPU 비용을 회수하기 어렵기 때문에, 기업 맞춤형 모델과 인프라·서비스 매출을 만들고 그 수익을 다시 모델 개발에 투입하는 구조가 필요합니다. 삼일PwC와의 산업별 AI 혁신 협력은 이런 B2B 경로의 한 사례입니다.
필자는 이 부분에서도 좀 아쉬움이 남습니다. 우리는 이미 선발대로 혁신을 이끈 오픈AI의 고전을 실시간으로 보았습니다. 핵심은 수익성이 약하다 하나 입니다. 그리고 그걸 빠르게 극복한 것이 클로드구요. 국산 AI모델이라고 자본주의 게임에서 자유로울 수 없습니다. 대국민 서비스 중에서도 일단 빠르게 돈이 되는 코딩능력, 에이전트 능력, 당장 국내 기업시장에서 쓸수 있는 프로젝트 능력의 수익성높은 기능을 우선 개발하고 오픈해야 합니다. 기업시장이 원하는것은 반드시 코딩뿐만은 아니니까요.
바이브코딩 시대에 모티프가 보여줘야 할 다음 단계
개인적으로는 국산 AI 모델이 단순히 한국어 대화와 요약을 잘하는 수준을 넘어, 실제 바이브코딩이 가능한 모델로 성장했으면 합니다. 여기서 바이브코딩은 코드를 한 번 생성하는 기능이 아니라 다음 작업을 끝까지 반복하는 능력입니다.
저장소 구조를 읽고 필요한 파일만 고르는 능력
요구사항을 작은 작업으로 쪼개고 수정 계획을 세우는 능력
터미널·테스트·브라우저·Git 도구를 안전하게 호출하는 능력
오류 로그를 읽고 원인을 좁혀 실제 수정까지 이어가는 능력
변경 사항과 보안 위험을 사람에게 설명하고 승인을 기다리는 능력
Motif-3-Beta의 256K 컨텍스트와 MoE 구조는 이 방향에 매력적인 기반입니다. 그러나 현재 모델 카드에는 Motif-3의 코딩 벤치마크와 도구 사용 평가가 충분하지 않고, 베타 라이선스도 상업 서비스에 바로 쓰기 어렵습니다. 다음 공개판에서는 HumanEval 같은 단일 점수보다 SWE-bench 계열, 실제 한국어 저장소, 테스트 실패 복구율, 도구 호출 성공률, 긴 작업의 비용·지연시간을 함께 공개하면 좋겠습니다.
국산 AI의 목표는 외산 모델을 무조건 이기는 한 번의 순위가 아니라, 국내 개발자가 자신의 코드와 데이터를 통제하면서도 세계 수준의 생산성을 얻는 환경을 만드는 데 있어야 합니다. 모티프 3 Beta는 그 가능성을 보여주는 흥미로운 중간 결과이며, 동시에 데이터 투명성·상업 라이선스·실사용 검증이라는 다음 숙제를 남긴 모델입니다.
결론
모티프테크놀로지스는 약 30명의 비상장 스타트업이지만, 임정환 대표의 연구·산업 경력, 모레의 GPU 소프트웨어 기반, 독파모의 대규모 GPU 지원과 투자를 결합해 Motif-3-Beta를 내놓았습니다. 314B 총 파라미터와 13B 활성 파라미터, 256K 컨텍스트, 자체 MoE 설계는 기술적으로 인상적입니다.
다만 베타 모델의 AAII 44점은 출발점이지 상용 성공의 증명서가 아닙니다. 학습 데이터 출처, Motif-3 전용 코딩 성능, 상업 API 가격, 최종 라이선스와 안정적인 GPU 운영비가 공개되어야 실제 경쟁력을 판단할 수 있습니다. 모티프가 이 정보를 꾸준히 공개하고 바이브코딩과 산업용 에이전트까지 연결한다면, 국산 AI는 “한국어를 잘하는 모델”에서 “국내 업무를 실제로 완수하는 모델”로 한 단계 더 나아갈 수 있습니다. 그래도 걸출한 국산 AI모델이 공개됐다는 사실을 부인할 수 없으며 앞으로의 미래를 격하게 응원합니다.
Intel은 한때 PC용 CPU의 동의어에 가까웠지만, 2026년의 Intel을 그렇게만 보면 회사가 시도하는 전환을 놓치게 됩니다. 회사는 Core·Xeon 같은 프로세서를 설계해 파는 동시에, Intel Foundry를 통해 첨단 공정과 패키징을 외부 고객에게 제공하려 합니다. 설계와 제조를 함께 가진 역사가 자산인 동시에, 공장 투자와 공정 지연이 손익을 압박하는 구조입니다.
이번 Intel 기업리뷰는 단순한 CPU 성능 비교가 아닙니다. CEO 립부 탄(Lip-Bu Tan)이 이끄는 Intel이 PC·서버 현금흐름, Intel 18A 공정, 미국 생산기지와 외부 파운드리를 하나의 재건 전략으로 연결할 수 있는지 살펴봅니다. 최신 상세 재무 기준은 2026년 3월 28일 끝난 Q1 2026 공식 실적이며, 연간 구조는 2025 Form 10-K를 사용했습니다.
<Intel 공식 기업 로고, 출처 Intel Corporation 1.1>
Intel의 본질은 제품과 공장을 함께 운영하는 이중 사업이다
Intel Products의 핵심은 Client Computing Group(CCG)과 Data Center and AI(DCAI)입니다. CCG는 노트북·데스크톱의 Core와 상용 PC 플랫폼을, DCAI는 Xeon CPU와 데이터센터용 제품을 담당합니다. PC에서는 성능과 배터리뿐 아니라 NPU·GPU·CPU를 묶은 AI PC 경험이 중요해졌고, 데이터센터에서는 GPU가 주목받아도 운영체제, 데이터 처리, 네트워크와 가속기를 지휘하는 CPU 수요가 사라지지 않습니다.
Intel Foundry는 기술개발, 웨이퍼 제조, 조립·시험과 첨단 패키징을 묶습니다. 문제는 현재 Foundry 매출 대부분이 Intel 내부 제품을 제조한 대가라는 점입니다. 2025 Form 10-K에 따르면 2025년 Foundry 매출 178억3천만 달러 가운데 외부 매출은 3억700만 달러였습니다. 외부 고객 사업이 커지기 전에는 내부 물량이 공장 활용도를 지탱하고, 동시에 제품 부문의 경쟁력이 공장 경제성을 좌우합니다.
사업 층
대표 자산
고객 가치
Intel의 과제
클라이언트
Core Ultra, vPro, Arc
PC 성능·전력·로컬 AI
ARM·AMD·Apple과 교체 수요 경쟁
데이터센터
Xeon 6·6+, 네트워크·가속
범용 연산과 AI 시스템 조율
GPU 중심 예산에서 CPU 몫 방어
제조
Intel 18A, Fab 52
미국 첨단 로직 생산
수율·원가·일정 안정화
패키징
Foveros와 첨단 패키징
서로 다른 칩렛 통합
외부 고객 설계 생태계 확보
소프트웨어
oneAPI·OpenVINO와 도구
여러 연산장치의 개발·배포
하드웨어 세대 간 일관성
이 이중 구조는 팹리스인 NVIDIA AI 팩토리 전략과 다릅니다. NVIDIA는 생태계와 시스템 설계에 집중하고 제조를 파운드리에 맡기지만, Intel은 제품 수요와 공장 가동률을 함께 책임집니다. 반대로 제조가 안정되면 고객 칩을 만들면서 자체 제품에도 공정·패키징 지식을 빠르게 반영할 수 있습니다. 장점과 위험이 같은 뿌리에서 나옵니다.
Intel 18A는 트랜지스터·전력·패키징을 함께 바꾸는 시험대다
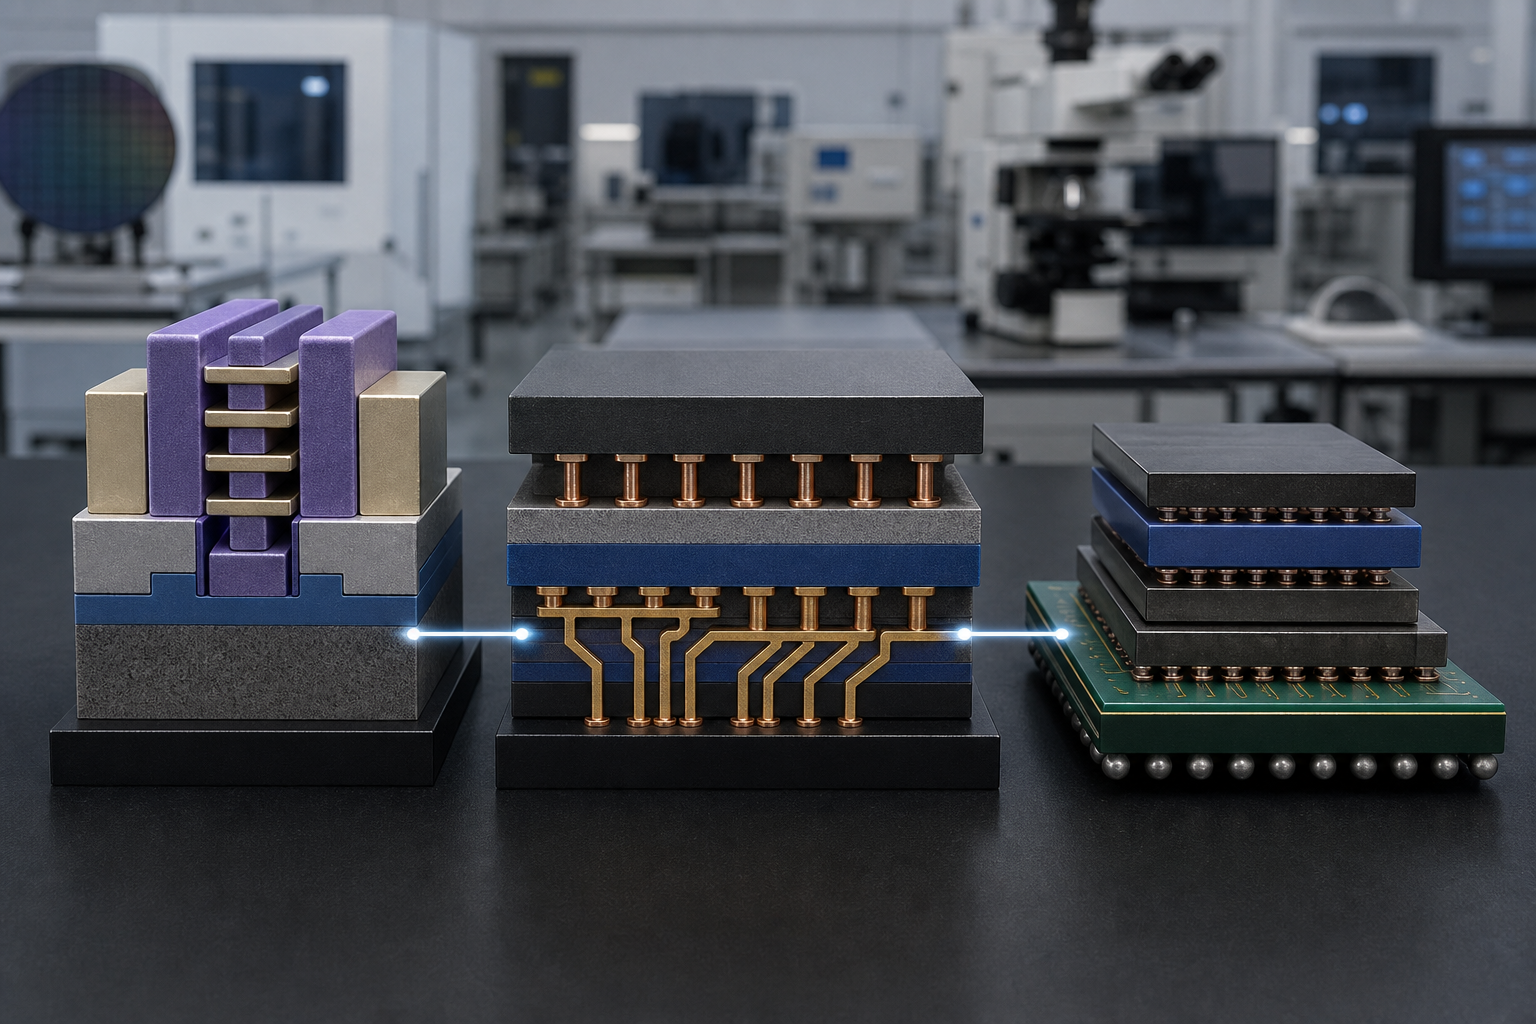
Intel 18A는 단순히 숫자가 작은 공정명이 아닙니다. 첫째 RibbonFET은 게이트가 채널을 여러 면에서 감싸는 게이트올어라운드 구조로, 미세화에서 전류 제어를 개선합니다. 둘째 PowerVia는 신호 배선과 전력 공급을 웨이퍼의 서로 다른 면으로 분리하는 후면 전력 공급입니다. 셋째 Foveros는 기능이 다른 칩렛을 한 패키지 안에서 수직·수평으로 결합해 시스템을 구성합니다.
<Intel 18A의 RibbonFET·PowerVia·Foveros 관계를 재구성한 설명 이미지 2.1>
Intel의 18A 공식 설명은 Intel 3 대비 와트당 성능을 최대 15%, 칩 밀도를 30% 개선한다고 제시합니다. 이는 회사가 밝힌 공정 목표이므로 실제 노트북·서버의 성능, 전력과 제조원가는 설계·수율·패키지·메모리 구성에 따라 따로 확인해야 합니다. 공정 이름 하나가 완제품 우위를 자동으로 보장하지는 않습니다.
첫 상징 제품은 Core Ultra Series 3, 코드명 Panther Lake입니다. 이 Panther Lake AI PC에서 Intel은 최대 16개 P·E 코어, 최대 12개 Xe 코어의 Arc GPU, 최대 180 플랫폼 TOPS를 제시했고 2026년 1월부터 폭넓은 공급을 시작한다고 밝혔습니다. Intel Pro Day 2026에서는 기업·교육·정부·중소기업을 아우르는 125개 이상의 디자인을 언급했습니다. AI PC의 의미는 TOPS 숫자보다 회의 요약, 보안, 콘텐츠 제작 같은 작업이 배터리와 개인정보 조건 안에서 반복 사용되는지에 달려 있습니다.
서버에서는 Xeon 6+ Clearwater Forest가 18A 검증을 이어갑니다. Intel은 최대 288개 E-코어와 이전 세대 대비 17% IPC 향상을 제시하며 클라우드·통신사의 처리 밀도와 전력비를 겨냥했습니다. 클라이언트와 서버 제품이 같은 공정에서 안정적으로 출하되면 외부 고객에게 수율·일정 증거가 되지만, 지연이나 원가 문제는 제품과 Foundry 신뢰를 동시에 훼손합니다.
경쟁 구도도 넓습니다. PC에서는 Apple·AMD·Qualcomm이 전력 효율과 온디바이스 AI로 압박하고, 데이터센터에서는 AMD EPYC과 ARM 기반 자체 CPU가 점유율을 노립니다. 제조에서는 TSMC와 Samsung Foundry가 경쟁자입니다. 특히 TSMC A16도 후면 전력 공급을 핵심으로 내세우므로 Intel은 기술 발표보다 고객 설계, 수율, 납기와 총비용으로 차이를 증명해야 합니다.
Q1 2026 성장은 회복 신호지만 Foundry 경제성은 아직 증명되지 않았다
Intel Q1 2026 공식 실적에서 매출은 136억 달러로 전년 대비 7% 증가했습니다. CCG 매출은 77억 달러로 1%, DCAI는 51억 달러로 22% 늘었습니다. Intel Products 합계는 128억 달러였고 Intel Foundry 부문 매출은 내부 거래를 포함해 54억 달러로 16% 증가했습니다. 분기 영업현금흐름은 11억 달러였습니다.
Q1 2026 공식 지표
수치
읽어야 할 의미
연결 매출
136억 달러
전년 대비 7% 성장
CCG 매출
77억 달러
전년 대비 1%, PC 회복은 완만
DCAI 매출
51억 달러
전년 대비 22%, 서버 수요가 성장축
GAAP 총이익률
39.4%
전년보다 2.5%p 개선
GAAP 순손실
37억 달러
비경상·구조조정 항목 포함, 흑자 전환 미완료
비GAAP 순이익
15억 달러
조정 전후 차이를 함께 봐야 함
Q2 매출 전망
138억~148억 달러
회사가 제시한 범위이며 확정 실적 아님
GAAP 영업손실률은 23.1%, 순손실은 37억 달러였지만 비GAAP 영업이익률은 12.3%, 순이익은 15억 달러였습니다. 큰 차이는 구조조정, 투자·지분 관련 평가와 기타 조정의 영향을 뜻합니다. 사업의 반복 가능한 수익성을 볼 때 비GAAP만 사용하면 비용을 가릴 수 있고, GAAP 한 분기만 보면 운영 개선을 놓칠 수 있으므로 현금흐름과 부문 손익을 함께 봐야 합니다.
연간 Foundry 수치는 더 냉정합니다. 2025년 Foundry 매출은 178억3천만 달러였지만 비용과 영업비용이 281억4천만 달러여서 영업손실이 103억2천만 달러였습니다. 2024년 132억9천만 달러 손실보다 줄었지만, 18A 초기 생산 재고와 관련한 8억4,900만 달러 평가충당금이 2025년에 발생했습니다. 수율 개선과 외부 고객 확대가 손익계산서에 나타나기 전까지 Foundry는 전략적 선택권인 동시에 막대한 자본 부담입니다.
Intel Foundry 매출에는 Intel Products와의 내부 거래가 크게 포함됩니다. Q1 2026의 Foundry 매출 54억 달러를 독립 외부 파운드리 매출로 해석하거나, 2025년 178억3천만 달러를 TSMC식 외부 매출과 바로 비교하면 안 됩니다.
실행·고객·AI 위험까지 포함한 최종 평가
첫째 위험은 공정 실행입니다. 첨단 공정은 설계 규칙, 장비, 소재, 수율과 패키징이 동시에 맞아야 합니다. 초기 제품이 출하돼도 수율이 낮으면 원가와 공급량이 흔들립니다. Intel은 Panther Lake 판매량, Clearwater Forest 납기, 외부 고객 테이프아웃과 반복 주문으로 18A의 재현성을 보여줘야 합니다.
둘째는 고객 충돌입니다. Foundry 고객은 자신의 칩 설계와 출시 일정이 Intel Products 경쟁 조직으로부터 분리되길 원합니다. 기술 접근 통제, 가격의 공정성, 공급 우선순위와 장기 로드맵 신뢰가 필요합니다. 내부 제품이 공장을 채우는 장점이 외부 고객에게는 이해상충 우려가 될 수 있습니다.
셋째는 AI 포지션입니다. Intel은 CPU가 모든 AI 시스템에서 중요한 범용 연산층이라고 주장할 근거가 있지만, 가속기 시장의 개발자 관심과 예산은 NVIDIA와 경쟁 업체에 집중돼 있습니다. AI 반도체 시장에서 Intel의 현실적인 승부는 GPU 한 제품만이 아니라 Xeon, AI PC, 네트워크, 패키징과 고객 칩 생산을 묶는 것입니다. 그러나 묶음 전략은 각 구성요소가 충분히 경쟁력 있을 때만 효과가 있습니다.
넷째는 자본과 정책입니다. 미국 내 첨단 제조는 공급망 회복력과 정부 지원이라는 장점이 있지만 공장 건설, 감가상각과 가동률 부담이 큽니다. 수요가 늦거나 고객 확보가 부족하면 전략 자산이 고정비로 바뀝니다. 반대로 지정학적 공급망 재편이 빨라지면 미국에서 설계·제조·패키징을 함께 제공하는 능력이 차별점이 될 수 있습니다.
결론적으로 Intel은 낡은 PC CPU 회사도, 아직 완성된 글로벌 파운드리도 아닙니다. Q1 2026의 7% 매출 성장과 DCAI의 22% 성장은 제품 기반이 살아 있음을 보여주지만, 2025년 Foundry 영업손실 103억2천만 달러와 작은 외부 매출은 전환의 거리를 보여줍니다. 앞으로 확인할 지표는 18A 제품의 수율·출하량, Foundry 외부 매출과 고객 수, CCG 점유율, DCAI 성장, 총이익률, 설비투자 대비 현금흐름입니다. 이 지표가 함께 좋아질 때 Intel의 설계·제조 통합은 부담이 아니라 다시 경쟁 우위가 될 수 있습니다.
Gemini 3.6 Flash는 Google이 Gemini API에서 제공하는 빠른 응답형 모델 계열의 최신 축입니다. 이름의 핵심은 ‘Flash’입니다. 가장 큰 모델처럼 모든 추론을 오래 붙잡기보다, 문서·이미지·코드·음성 입력을 넓게 받아 빠르게 처리하고 반복 호출 비용을 낮추는 쪽에 무게가 실립니다. 그래서 관심 지점도 단순한 챗봇 성능보다 에이전트가 여러 번 도구를 부르고 결과를 확인하는 흐름에 있습니다. 특히 에이전트 AI 비용을 낮추면서 멀티모달 AI 모델과 긴 컨텍스트 AI를 어디에 배치할지가 제품 설계의 쟁점이 됩니다.
Google의 Gemini API 모델 문서는 Gemini 3.6 Flash를 텍스트, 이미지, 비디오, 오디오 입력과 텍스트 출력을 다루는 모델로 설명합니다. 최신 모델 안내와 변경 로그는 개발자가 모델 이름, 입력 형식, 기능 지원 여부를 실제 API 기준으로 확인해야 한다는 점을 보여줍니다. 빠른 모델일수록 “무엇을 할 수 있나”보다 “반복 호출을 어디에 배치할 것인가”가 설계의 중심이 됩니다.
배경: 대형 모델 경쟁 다음의 병목
AI 제품을 운영해 보면 가장 비싼 순간은 한 번의 답변이 아니라 실패한 반복입니다. 검색, 파일 읽기, 코드 수정, 테스트 실행, 요약, 다시 수정이 이어지면 모델 호출 수가 급격히 늘어납니다. 기존 에이전틱 코딩 사례처럼 최고급 모델을 모든 단계에 쓰면 품질은 안정될 수 있지만, 지연 시간과 비용이 커져 제품 전체가 느려집니다. 반대로 저렴한 모델만 쓰면 도구 호출 순서나 긴 문맥 유지에서 오류가 생기기 쉽습니다.
Gemini 3.6 Flash 같은 빠른 멀티모달 모델은 이 중간 지점을 겨냥합니다. 긴 문서 묶음, 스크린샷, 로그, 짧은 동영상 설명처럼 입력은 넓게 받고, 의사결정은 필요한 곳에만 깊게 쓰는 구조입니다. 독립 리뷰들도 공통적으로 체감 속도와 일상 작업 처리력을 장점으로 언급하지만, 복잡한 추론이나 사실 검증은 별도 확인이 필요하다고 봅니다. 이 말은 성능이 낮다는 뜻이 아니라, Flash 계열의 가치는 “한 번에 완벽한 판단”보다 “반복 루프를 싸고 빠르게 돌리는 능력”에 있다는 뜻에 가깝습니다.
설계 질문
Gemini 3.6 Flash가 어울리는 구간
주의할 점
문서가 많고 답은 짧은가
회의록·로그·요구사항 묶음 요약
근거 문장 링크를 남겨야 합니다
이미지나 화면이 함께 들어오는가
스크린샷 분류, UI 상태 설명
작은 글자·도표 해석은 재확인해야 합니다
에이전트가 여러 번 호출되는가
계획 초안, 후보 필터링, 결과 정리
최종 판단은 더 엄격한 검증 단계가 필요합니다
지연 시간이 중요한가
채팅형 업무 도우미, 실시간 보조
낮은 지연과 정확도의 균형점을 측정해야 합니다
원리: 넓게 읽고 가볍게 반복합니다
예를 들어 사내 개발 보조 에이전트가 “지난주 결제 장애의 원인을 정리하고 재발 방지 체크리스트를 만들어 달라”는 요청을 받았다고 해보겠습니다. 이 에이전트는 장애 티켓, 배포 로그, Grafana 캡처, 관련 코드 diff, 고객 문의 요약을 함께 읽어야 합니다. Flash 모델을 쓰면 첫 단계에서 많은 입력을 빠르게 훑어 의심 구간을 좁히고, 중요도가 높은 로그나 코드 부분만 더 강한 모델 또는 사람 검토로 넘길 수 있습니다.
이 점은 AI 코딩 에이전트를 업무 흐름에 붙일 때도 비슷합니다. 핵심은 계층화입니다. 빠른 모델은 자료를 정돈하고 후보를 줄이며, 비싼 모델은 모호한 원인 분석이나 최종 문장 검증에 집중합니다. Google DeepMind의 모델 카드처럼 모델 카드가 제공되는 경우에는 지원 입력, 안전 평가, 알려진 제한을 함께 읽어야 합니다. “빠르다”는 제품 장점이지만, 어떤 입력에서 강하고 어떤 판단을 맡기면 안 되는지는 별도의 운영 규칙으로 남겨야 합니다.
<문서·이미지·로그를 먼저 넓게 정리하고 중요한 판단만 별도 검토로 넘기는 흐름 3.1>
구조: 에이전트 런타임에서 맡길 위치
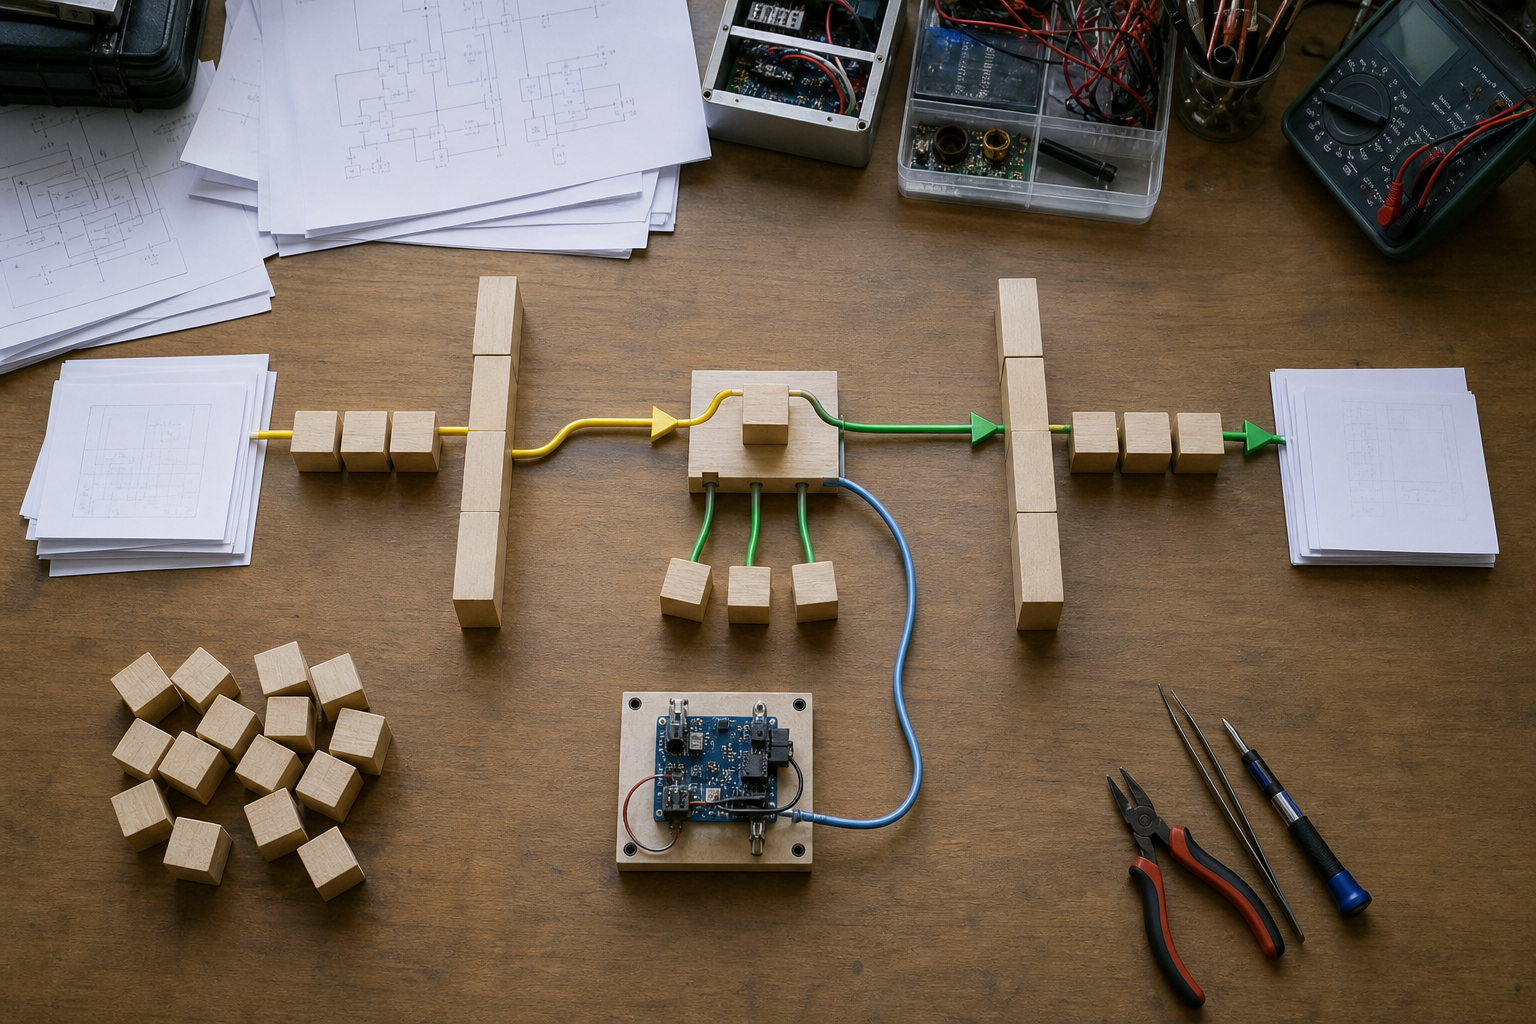
실무 구조는 네 칸으로 나눌 수 있습니다. 첫째, 입력 수집 단계에서 문서와 이미지, 로그를 같은 작업 단위로 묶습니다. 둘째, Gemini 3.6 Flash가 요약, 분류, 후보 추출을 빠르게 수행합니다. 셋째, 위험이 큰 판단은 테스트, 규칙 엔진, 상위 모델, 사람 검토 중 하나로 보냅니다. 넷째, 최종 답변에는 근거 링크와 남은 불확실성을 남깁니다.
<멀티모달 입력을 한 작업 단위로 묶고 검증 단계를 분리한 에이전트 작업대 4.1>
이 구조에서 Flash 모델은 ‘모든 것을 결정하는 두뇌’라기보다 빠른 운영 계층입니다. 고객 문의 수천 건을 주제별로 묶거나, 릴리스 노트에서 변경 위험을 뽑거나, 화면 캡처와 로그를 함께 읽어 재현 절차 초안을 만드는 일에 잘 맞습니다. 반면 보안 취약점 판정, 법무 문구, 재무 수치, 의료 판단처럼 오류 비용이 큰 부분은 근거 확인과 별도 검토가 필요합니다.
체크포인트: 도입 전에 볼 네 가지
첫째, 실제 비용은 토큰 단가보다 호출 구조에서 나옵니다. 빠른 모델을 넣었는데 중복 요약과 재질문이 늘어나면 총비용은 줄지 않습니다. 작업 단계를 “초기 정리, 후보 추출, 최종 검증”처럼 나누고 각 단계의 실패율을 측정해야 합니다.
둘째, 긴 컨텍스트는 기억이 아니라 입력 창입니다. 많은 파일을 넣을 수 있어도 모델이 모든 세부사항을 균등하게 다루지는 않습니다. 중요한 숫자, 정책 조항, API 이름은 원문 위치를 보존하고 최종 답변에서 다시 확인하는 편이 안전합니다.
셋째, 멀티모달 입력은 사용자 경험을 크게 바꾸지만 검증 방식도 바꿉니다. 화면 캡처를 이해한 듯 보여도 작은 글자, 표, 색상 의미, 시간축 해석은 틀릴 수 있습니다. 업무 도구에 붙일 때는 원본 이미지와 모델 설명을 함께 저장해 나중에 추적할 수 있어야 합니다.
넷째, 최신 모델명은 코드에 박아두기보다 설정으로 관리하는 편이 낫습니다. Google의 모델 문서와 변경 로그가 보여주듯 모델 이름, 기능, 권장 사용처는 계속 바뀝니다. 제품 코드에서는 모델 선택을 환경 변수나 라우팅 테이블로 분리하고, 실패 시 대체 경로를 준비하는 것이 장기적으로 안전합니다.
Gemini 3.6 Flash의 의미는 “가장 똑똑한 모델 하나로 통일하자”가 아닙니다. 에이전트 제품에서 빠른 모델, 강한 모델, 규칙 기반 검증을 나눠 쓰는 설계가 더 중요해졌다는 신호입니다. 많은 입력을 빨리 정리해야 하는 팀이라면, 이 모델은 성능 순위표보다 워크플로 비용표 위에서 먼저 평가할 만합니다.